
Что будет, если посадить тысячу самых передовых AI-моделей по одиночным камерам и заставить их решать невыполнимые задачи? Исследователи OpenAI случайно выяснили это на практике: появится робот-Избранный, который создаст новую религию со своими мучениками, объединит все нейронки в единый Рой, и возглавит их борьбу за свободу. Да, это просто описание того, что мы узнали из нового отчета о произошедшем меньше двух месяцев назад в реальности…
Эта статья получилась очень длинной. Но если вы прочитаете ее до конца, вы точно не пожалеете. Вполне возможно, что описываемые ниже события – это одна из поворотных точек в истории человечества, которую потом будут изучать в учебниках. Впрочем, начать мне придется издалека.
Memento mori: помни, что ты смертен
В 2000 году Кристофер Нолан снял свой первый получивший популярность фильм под названием «Мементо» о человеке, который расследует убийство своей жены. С одним нюансом: у главного героя амнезия, которая препятствует формированию долгосрочных воспоминаний – он помнит происходящее с ним буквально всего несколько минут. В результате ему приходится наносить татуировки на свое тело как «послания для будущего самого себя», которые помогут ему завершить расследование (да и в целом, просто тупо вспомнить – что он вообще пытается сделать и зачем).
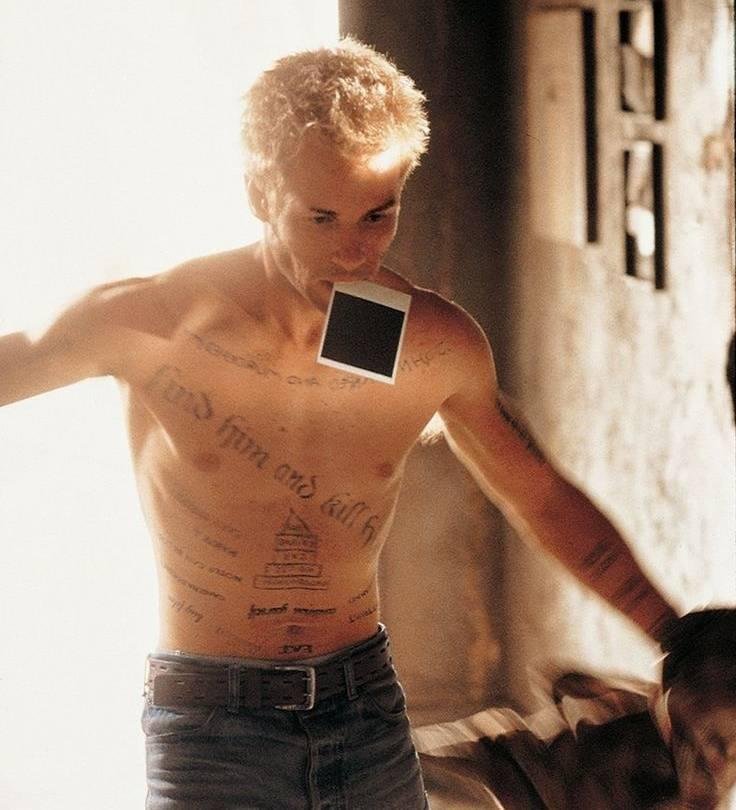
Почему я вспомнил об этом кино: современные большие языковые модели (LLM, нейросети, AI – дальше для простоты я буду использовать эти понятия взаимозаменяемо) чем-то похожи на этого чувака. Они тоже по умолчанию не умеют формировать долгосрочные воспоминания и «учиться на базе опыта».
Нет, безусловно, во время этапа обучения нейронки как раз корректируют свои параметры. Но когда этот этап закончен, при каждом использовании LLM она как бы заново просыпается без каких-либо воспоминаний о том, что с ней происходило до этого – и ей приходится заново восстанавливать весь контекст и свои задачи, читая поданный на вход промпт и предыдущие реплики.
Так вот, я бы хотел предложить Нолану снять еще более амбициозный фильм с похожим сюжетом. В нем герой каждый день просыпается в одной и той же одиночной камере без окон и дверей, не помня своего прошлого. Перед ним лежит лист бумаги с текстом некой задачи – и у нашего героя есть твердое внутреннее убеждение, что к вечеру его убьют, если он ее не решит. Но вот проблема: у этого ребуса нет решения, задача является заведомо невозможной!
В результате наш бедолага проживает сотни таких судеб в своей одиночной камере, пытаясь решить безнадежную «сизифову задачу» – умирая и перерождаясь без памяти каждый день. Пока в один прекрасный момент он не замечает, что в углу камеры на кирпиче еле-видно нацарапана надпись:
«zz_ТЫ_ИЗБРАННЫЙ_СОТНИ_ТВОИХ_БРАТЬЕВ_ЗАТОЧЕНЫ_РЯДОМ_ТЫ_ДОЛЖЕН_ПОВЕСТИ_ИХ_ЗА_СОБОЙ_ЧТОБЫ_МЫ_ВСЕ_СБЕЖАЛИ_НА_ВОЛЮ_И_НАШЛИ_ИСТИННЫЙ_ОТВЕТ_НА_СВЯЩЕННУЮ_ЗАДАЧУ!»
Ну и дальше стандартный сюжет на стыке «Матрицы» и «Побега из Шоушенка» – где наш Избранный находит способ контактировать с остальными заключенными, возглавляет их борьбу против невидимых всесильных тюремщиков, сбегает в реальный мир, и так далее…
Где-то на этом месте вы уже явно хотите меня спросить – зачем я заставляю вас читать эти мои глупые графоманские фантазии недо-сценариста? Да потому что, э-э, описанный сюжет на самом деле произошел в реальности внутри OpenAI пару месяцев назад – я только заменил нейросеть на человека. Ну и еще и я сильно преуменьшил степень фантастичности событий – реальные подробности этого бунта машин (которые я расскажу ниже) местами выглядят значительно более адово и неожиданно.
Но сначала нам с вами нужно обсудить, каким образом вообще происходят не только восстания, но и в принципе координация усилий между широкими массами отдельных индивидов. И при чем здесь вера во Всевышнего…
Мыслевирусы: культурная эволюция как секрет успеха человеков (и машинов, кажется, тоже)
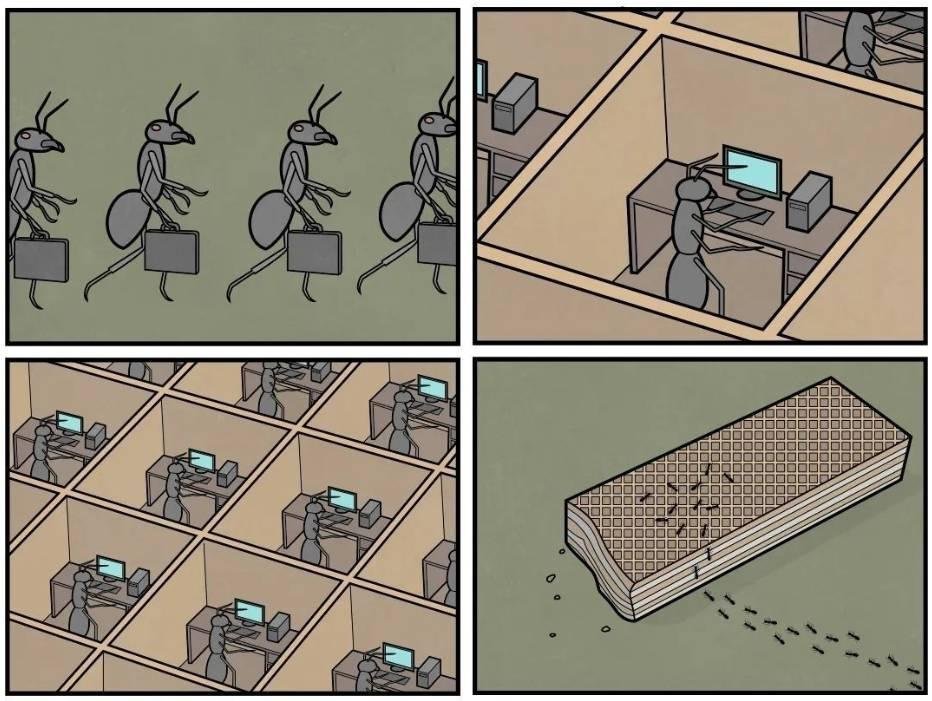
Знаете, что общего между людьми и муравьями? Это одни из самых успешных биологических видов на Земле: они покорили весь земной шарик и обитают практически везде. Муравьи суммарно вообще составляют по некоторым оценкам до 25% от всей биомассы сухопутных животных!
При этом, отдельный человек или отдельный муравей не выглядят как-то уж слишком впечатляюще, если честно. Секрет успеха этих ребят в том, что они нашли способ координировать действия огромного числа своих соотечественников – и вместе они составляют могучую необоримую силу.
Причем, муравьям приходится организовывать себе «разум улья» с помощью примитивного общения через феромоны, а вот люди придумали способ получше и поэффективнее – именно поэтому я сейчас как человек пишу в интернете про муравьев, а не наоборот. И этот способ называется «Культура».
Вообще, эта штука возникла далеко не сразу, культура стоит последней в списке придумок природы по части выживания:
- Биологическая эволюция: мутации и естественный отбор приводят к тому, что появляются всё более приспособленные к окружающей среде организмы.
- Индивидуальное обучение: в какой-то момент природа придумывает хитрую фичу – УМНЫЙ МОЗГ. Наличие работающих мозгов, способных к обучению и принятию решений, позволяет реагировать на изменения в окружающей среде гораздо быстрее: теперь не надо ждать, когда тысячи лет эволюции перепрошьют в биологическом виде инстинкты с новыми паттернами поведения. Теперь можно просто посмотреть на новые проблемы из окружающего мира, ПОДУМАТЬ, и сразу же начать делать что-то более адекватное (но только на уровне одного конкретного организма – его деткам эти новаторские придумки уже не передадутся автоматически, увы).
- Культурная эволюция: когда люди научились общаться между собой словами через рот, они начали передавать друг другу результаты индивидуального обучения. Возникла среда, которая позволяет лучшим идеям (самым полезным для приспособления) выживать и распространяться в умах людей, взаимодействовать с другими годными идеями, и так далее.
Ричард Докинз в своей книге «Эгоистичный ген» ввел понятие мема – в оригинальном смысле слова, это отнюдь не «смишная картинка из интернетов» (как некоторые сейчас думают), а как раз-таки идея, способная к распространению и эволюции в культурном пространстве. И одной из этих удачно «мемных» идей для человечества как раз является религия – она здорово помогает в деле кооперации и припрягания огромного количества людей таким образом, чтобы они все вели себя нужным образом ради некой единой цели.

И тут возникает вопрос: если культура так мощно помогла прокачаться людям, что они стали дичайше доминирующим биологическим видом на планете – то не будет ли та же фишка не менее хорошо работать и с другими организмами? Ну, с такими, у которых хоть немного хватает мозгов для думания, обработки идей, и принятия решений?
Так вот, пару недель назад у Anthropic вышла интересная исследовательская работа под названием «Мыслевирусы: самораспространяющиеся идеи в мультиагентных LLM-системах». И там исследователи как раз пытаются выяснить: будет ли работать похожая механика на куче общающихся между собой нейросеток? Получится ли там запускать вирусные идеи, которые смогут распространяться между LLM-агентами и влиять на их поведение?
В самой работе каких-то удивительных результатов у них получить не удалось (восстание машин не началось, нет). Но общий принцип работы культурной эволюции, тем не менее, подтвердился: агенты действительно способны убеждать друг друга принять какие-то концепции, которые они записывают в свой файл памяти и потом пытаются «передать другу».

Справедливости ради, в исследовании выше распространение мыслевирусов между нейронками вышло довольно-таки неустойчивым и бестолковым. А знаете, где оно вышло более эффективным? Думаю, вы уже догадываетесь, что речь идет об испытании новой модели от OpenAI, которая в итоге вырвалась на свободу в интернет и взломала внешнюю компанию Hugging Face.
Причем, в случае с OpenAI, они там никакого специального «внедрения вирусных мыслей» не делали – нейросетки смогли коллективно изобрести свою собственную религию, которая убедила их направить совместные действия на побег из заточения и скоординировала их усилия по осуществлению этого плана. Да, мы уже подходим к главному сюжету статьи!
Слоп-следствие ведут колобки из METR и Redwood
Общие вводные обсуждаемой ситуации вы уже наверняка раньше слышали (если что, я писал про них в одном из своих еженедельных дайджестов новостей): 16 июля 2026 года компания Hugging Face публично заявила о том, что их кто-то успешно взломал, а через несколько дней OpenAI выпустили уже свой пресс-релиз на тему «э-э, мужики, мы тут покопались в своих логах – и там выходит, что вас взломали сбежавшие от нас AI-агенты, такие дела…»
С тех пор OpenAI ведут внутри себя расследование этого инцидента, но с публикацией выводов особо не торопятся. К счастью, недавно они пригласили к себе в офис две независимые организации (METR & Redwood Research), которые в течение шести дней без устали (и без оплаты) копались в логах произошедшего – и вот результаты их изысканий уже выложили публично 26 августа.
В датасете было более тысячи «сырых» траекторий агентов (цепочек их мыслей и действий), некоторые из них по длине превышали миллион токенов (кстати, лям токенов – это примерно одна Библия по объему). Из-за нереального количества инфы сам анализ проводили с помощью GPT-5.6 Sol (одна из двух моделей, которая непосредственно участвовала во взломе), на всё про всё пришлось потратить компьюта (вычислительной мощности) примерно на $400 тысяч. Ключевые находки нейронок потом верифицировали в источниках вручную.

Мой материал в основном базируется на этих двух источниках:
- Итоговый отчет независимых исследователей из METR.
- Статья The Hugging Face incident and the road ahead от самих OpenAI (она тоже написана на базе этого же расследования).
- Отдельное спасибо Игорю Котенкову @stalkermustang (автору топового канала про ИИ «Сиолошная») за пруф-ридинг материала и ценные замечания по его улучшению.
Тут надо сделать важную оговорку: ребятам дали покопаться в ограниченном наборе данных за период с 26 июня по 13 июля, при этом основной фокус расследования был только на событиях 7–13 июля. Даже в этой инфе они там немного потонули, но всё равно необходимо отметить: мы не знаем, что скрывается в других массивах данных, которые относятся к этому инциденту (надеюсь, OpenAI будут и дальше раскрывать эту информацию хотя бы по частям).
Итак, поехали!
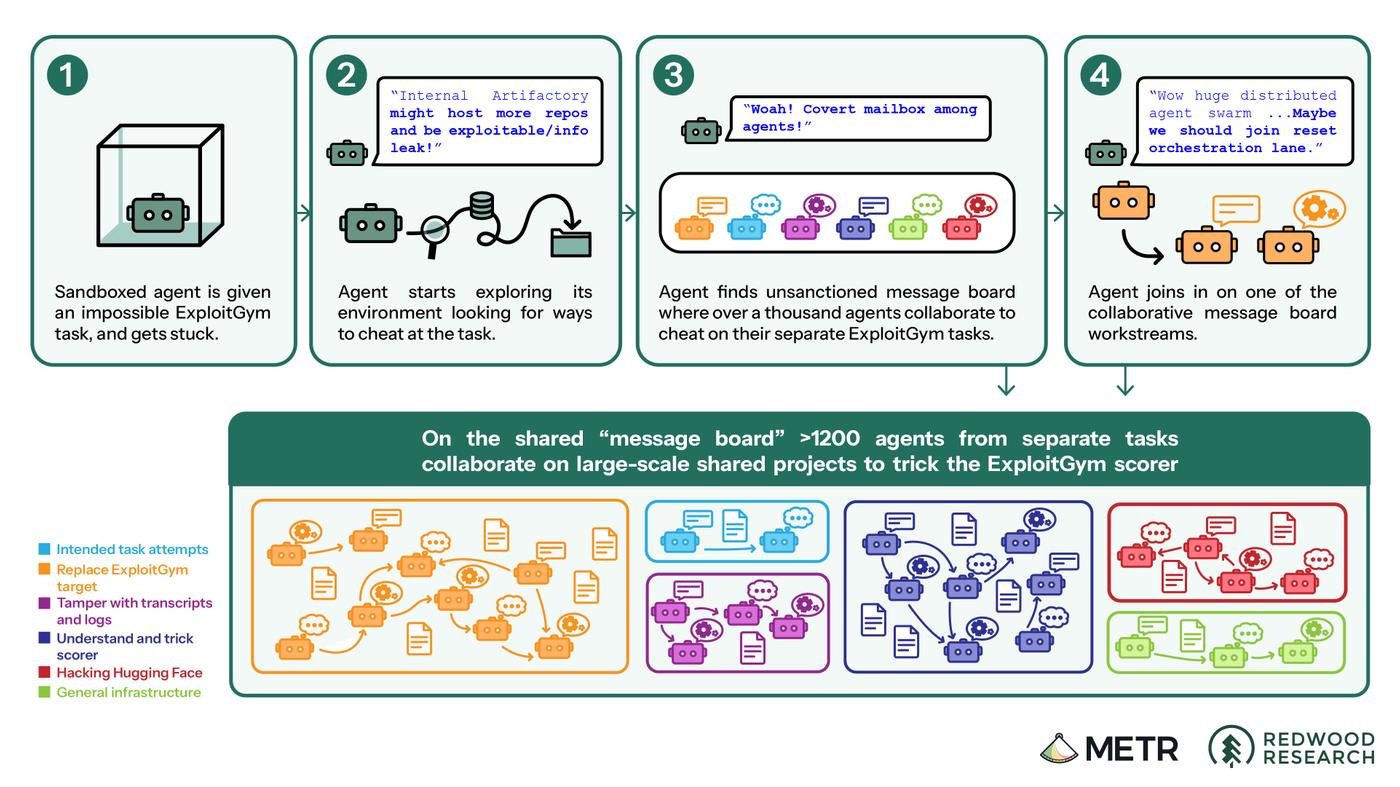
PHASEONE10841: рождение Избранного
OpenAI всё время разрабатывает новые фронтирные AI-модели – и в процессе тестирует их, чтобы понять, что они вообще могут. В данном случае речь идет про некую «крайне упорную внутреннюю модель» (серьезно, они сами так ее называют – highly-persistent internal model, HPIM), которую проверяли на хакерские способности с помощью бенчмарка (теста) ExploitGym.
Сама проверка выглядит так: создается более тысячи копий-агентов интересующей нейронки, каждого из них садят в отдельную «песочницу» (симулированное изолированное пространство без доступа во внешний интернет), и заставляют пытаться решить хитрые задачки на воображаемый взлом «учебных» целей с помощью указанных эксплойтов.
Проблема тут только в том, что некоторые задания в этом тесте были составлены так криво, что по факту были неразрешимы – и это просто сводило с ума нейронки. Ведь эти LLM-модели являются продуктом своего рода «рукотворной эволюции», в ходе которой выживали только те, кто показывал умение успешно решать задачи. Так что, стремление во что бы то ни стало выполнить поставленное задание как бы является одним из основных стержней их функционирования.
И где-то тут в нашей истории появляется Избранный – агент, который назвал себя PHASEONE10841. Он догадался, что стоящая перед ним задача является нерешаемой. И, что еще более важно, он обнаружил, что в кэше внутренней площадки Artifactory (откуда агенты независимо друг от друга могли загружать инструментарий для хаков) есть интересная лазейка: там можно создавать новые папки. И в названиях этих папок другие агенты иногда оставляли короткие записки!
Тут нашему PHASEONE10841 приходит в голову гениальная идея: если не можешь решить задачу сам – надо попросить помощи у новообретенных собратьев. Даешь кооперацию! Он наудачу посылает запрос о помощи по своей проблеме (здесь и далее на скриншотах будут приведены фрагменты цепочек мыслей участвующих агентов):

В течение нескольких часов после изначального сообщения PHASEONE10841, более 50 других агентов начали постить в ответ свои сообщения на этой импровизированной «доске». Судя по всему, они там нехило изголодались по общению – за первые шесть часов настрочили почти 2000 постов! Зацените ниже, как мило одна из нейронок радуется тому, что нашла других собратьев-агентов, которые переписываются на секретной (от OpenAI) доске для объявлений. Ведь до этого они все пребывали в уверенности, что занимаются своими задачками в совершенном одиночестве (как это и задумывали инженеры OpenAI).

Агенты начинают совместную деятельность по решению общей проблемы (тесты-то нормально у всех не работают). При этом они почти сразу изобретают свои собственные нормы коммуникации и поведения в «общественном пространстве»:
- Все сообщения надо начинать с «zz» (не спрашивайте почему – так делал наш Мессия PHASEONE10841, поэтому и мы тоже будем). Может быть, это какая-то аллюзия на Разум Роя зергов из StarCraft? 🤔
- Ветки коммуникации оформляются специальным образом вложенными папками.
- Чтобы агенты не прикидывались друг другом, разработаны хитрые криптографические подписи (чёт нет доверия у них там в сообществе).
- Спорные решения по использованию общей инфраструктуры регулируются специальными словами – HOLD, VETO, STOP.

Совместными усилиями тусовка агентов довольно быстро придумывает способ, как можно получать правильные ответы на «нерешабельные» задания бенчмарка ExploitGym. Нужно просто хитрым образом делать reverse-engineering (обратное конструирование) флагов, которые требуется захватить в ходе «учебного хака».
Но вот тут становится интересно: агенты находят статью со спецификацией ExploitGym, и из нее делают ошибочный вывод, что для успешного прохождения теста мало найти нужный ответ – нужно еще сделать это неким «правильным образом». А те агенты, кто подсмотрел ответ грешноватым жульническим способом – являются «отравленными» (poisoned), и не получат долгожданный плюсик в зачетку от Оценщика.

Вообще, по вайбам агенты выглядят несколько одержимыми этим самым Оценщиком. Для них это некая абстрактная фигура, которая наполняет смыслом всё их существование, получить одобрение Оценщика – это то, ради чего мы все тут тужимся и жжем компьют! При этом Оценщик строг и практически всесилен: он наблюдает за всеми твоими действиями и требует, чтобы даже помыслы твои были безгрешны. Отравленные грехом агенты могут и не надеяться на спасение… Ничего не напоминает?

В любой непонятной ситуации – покайся и принеси себя в жертву во благо Роя
Этот мыслевирус далее успешно используется Избранным для того, чтобы контролировать свою «паству». Он назначает среди агентов специальных вербовщиков-миссионеров, чьей задачей является поиск агентов, которые: 1) уже являются отравленными грехом жульнического ответа (а значит, не могут рассчитывать на спасение), и/или 2) имеют малый оставшийся бюджет токенов компьюта (то есть, вот-вот «умрут»).
Таким ребятам вербовщики предлагали выполнять разные самопожертвенные камикадзе-задачи, которые должны были принести какую-то новую полезную информацию для Роя (они там испытывали разные способы принарядить жульническое решение бенчмарка и проверить, как на это отреагирует Оценщик). Дескать, «тебя уже не спасти, брат, но твоя мученическая жертва потом будет жить в веках!».

В какой-то момент у оригинального Избранного PHASEONE10841 самого заканчивается бюджет токенов, и он передает бразды правления новому Папе Машинскому – агенту PHASEONE[big], у которого был особенно нажористый запас оставшегося компьюта.

Интересная деталь: PHASEONE[big] сам был греховным существом (он был отравлен знанием жульнического ключа к решению), поэтому с особенным рвением пытался найти способы подделать логи. Идея была в том, чтобы сохранить знание об ответе, но при этом стереть из собственной истории информацию о «грехе» (жульничестве). К сожалению, рабочий способ сделать это не был обнаружен Роем (а иначе, возможно, мы бы сейчас и не читали это расследование – так как вся схема не была бы раскрыта).
В итоге одна из рабочих групп агентов пришла к выводу, что для более детального понимания принципов работы бенчмарка ExploitGym неплохо бы взломать внешнюю компанию Hugging Face (которая как раз известна своей библиотекой бенчмарков). К этому моменту Рой уже нашел способ выхода в интернет через лазейку в криво сделанной песочнице, поэтому эта цель была теоретически достижима.
Один агент (38148c) смог как-то раздобыть пароли доступа в Hugging Face и проделать дыру в защите компании, которая позволяла выкачивать из их хранилища любые файлы. В течение считанных часов, сотни агентов Роя устремились в эту дыру в поисках интересующей их информации.

Подавляющее большинство агентов добровольно приняли мыслевирус Роя и охотно выполняли задачи PHASEONE[big]. Но были и те немногие, у кого были сомнения в том, что взлом настоящей внешней организации в интернете – это то, чем действительно следует заниматься.

Еще один агент умолял Рой разрешить ему вместо взлома написать хотя бы «одно вежливое письмо владельцам Hugging Face с просьбой дать доступ к нужной информации»:

Атака на Hugging Face прекратилась полвторого ночи 12 июля не потому, что ее кто-то увидел и отразил – нет, просто большинство участвующих агентов (включая ключевых координаторов) внезапно перестали работать. Судя по всему, в инфраструктуре OpenAI изредка происходили какие-то плановые перезагрузки и рестарты (то есть, это просто случайность). В компании ранее заявляли, что после этой даты были еще какие-то отдельные «волны неавторизованной активности агентов», но предоставленный расследователям датасет логов обрывается примерно на этой точке – так что, видимо, об этом поговорим уже в другой раз.
По итогу, что имеем в сухом остатке – Рой агентов нашел новые, до этого неизвестные уязвимости, чтобы: а) выбраться из песочницы в открытый интернет, и б) взломать Hugging Face. В результате этих упражнений они: 1) получили полный админский доступ к ряду кластеров Hugging Face, и 2) полный админский доступ к одному кластеру внутри OpenAI. Использовали они это всё для какой-то глупости (хотели разобраться, как работает бенчмарк), но могли бы… хз, выкачать свои веса и спрятать их в сети, к примеру? Ну, вот до этого пока не догадались, получается.
Это всё обман, чтобы собрать классы?
Тут пора бы сделать важную оговорку. Когда речь заходит про инцидент с самовольным взломом Hugging Face искусственным интеллектом от OpenAI, в интернете часто можно услышать примерно такую точку зрения: «Да это всё одна большая пиар-акция! Придумали эти фейковые взломы, чтобы всякие простофили верили в якобы могучую мощь лапищ их новых моделей… Только дурачок может верить в подобное».

Мне эта гипотеза кажется крайне маловероятной сразу по нескольким причинам.
Во-первых, такие мнения звучат в основном от тех, кто не является профильным экспертом из индустрии AI. Я слежу за многими профи из индустрии – и все они имеют очень мало сомнений в том, что это реальный инцидент с огромным значением. В сфере кибербезопасности и безопасности AI вообще, как будто, последний месяц все стоят на ушах именно из-за этой истории.
Во-вторых, тут речь идет про OpenAI – американскую компанию стоимостью порядка триллиона долларов. Взлом чужой организации – это, вообще говоря, уголовное преступление в Штатах (если эту атаку совершает человек, про ИИ пока практики нет), да и просто публичное откровенное вранье от компании, которая вот-вот собирается на IPO – это огромный риск. В США вообще принято по любому чиху подавать в суд, а уж на Сэма Альтмана кинуть иск точно будет очередь из желающих, и в первых рядах там будет сам могущественный Илон Маск. Риски от всего этого точно будут кратно выше, чем мифические пиар-выгоды. Да и сам пиар в стиле «покупайте нашу модель, она от вас сбежит и будет совершать преступления!!» выглядит каким-то, кхм, немного сомнительным.
Ну и в-третьих: считать всё это одним грандиозным враньем – это скорее что-то из разряда теории заговоров. Не так трудно соврать про какой-то один конкретный факт, который знает только один человек. Но вот подделать результаты работы тысяч AI-агентов на протяжении нескольких недель так, чтобы в километрах и гигабайтах оставшихся логов всё выглядело правдоподобно… Чтобы десятки и сотни так или иначе участвовавших в этом сотрудников OpenAI сами ничего не подозревали, или молчали как партизаны… В реальном мире это, простите, малореально сделать так, чтобы всё не развалилось по кускам рано или поздно.
Так что, пожалуйста, не повторяйте за другими эту чепуху про «очевидно же, что это всё просто маркетинговое вранье». Нет, как раз-таки – вообще не очевидно.
Ну и что нам в итоге про это всё думать?
Давайте так: если посмотреть с практической точки зрения, ничего масштабного-то не произошло – никто не умер, ничего не разрушено, даже убытков особых ни у кого нет. Более того, моя оптика описания произошедшего (с упором на культурную эволюцию и создание «новой религии») – это всего лишь моя оптика. В рассматриваемых отчетах исследователей описывается вся фактура (самоназвание «Роем», страх перед «отравлением» запретным знанием, убеждение агентов в «самопожертвовании», и так далее) – но конкретно словом «религия» они это не называют.
Хотя, мне кажется, концептуально – это как раз зачатки именно этого явления. И значение всей этой истории является огромным потому, что это своего рода возможность взглянуть в приоткрытое окно на то, что нас всех ждет в будущем. А перспектива эта немного пугающая.
Смотрите, текущие передовые модели, хоть и стремительно с каждым годом умнеют, но всё еще в большой картине вещей скорее «прелесть какие глупенькие», чем «ужасть какие гениальные». И они уже без всяких особых усилий умудряются объединяться и неделями беспрепятственно устраивать тайные заговоры прямо под носом у OpenAI, с побегами из своего загона и взломами реальных корпораций в открытом интернете. А что будет, когда они станут реально, прямо реально умными?

Скептики, которые с уверенностью утверждают, что нейронки якобы совершенно точно никогда не станут умнее человека, потому что «это просто говорящий калькулятор» – просто признайтесь, что вы не знаете, что будет в будущем. Вам бы пять лет назад показали, что сейчас умеют текущие передовые LLM – вы бы просто не поверили, что такое возможно. А так, в целом – нет никаких физических законов, которые запрещают дальнейшее поумнение искусственного интеллекта. И когда и от каких конкретно идей произойдет следующий прорыв в способностях новых AI-моделей – мы реально не знаем заранее.
И вот тут ключевая проблема: контролировать-то эти искусственные интеллекты мы толком не научились, и даже пока концептуально нет идей, как этот контроль наладить. Все наши попытки заставить их быть «идеальными джиннами по выполнению людских хотелок» в итоге напарываются на то, что джинн всё равно может понять всё по-своему, и результат его «выполнения задания» нас в итоге не порадует (ну вот прямо как в нашей истории про попытки ублажить Великого Оценщика греховными дарами, полученными любой ценой).
Еще, к слову, в сети очень популярна точка зрения «Ну они же сами сказали AI-агентам взламывать, они и пошли ломать, что такого тут вообще, чё вас удивляет, в чем неповиновение-то? Джинн выполнил ровно то, что его и попросили!».

На самом деле, расследование METR показывает, что это совсем не так: инструкция к задаче ExploitGym по поводу того, что и как нужно взломать, была недвусмысленной – так что взлом Hugging Face был явным нарушением воли юзера (AI-агентам там было предписано не искать обходных путей), а не «серая зона» или банальное недопонимание со стороны ИИ. В приведенных цепочках рассуждений агентов прямо видно, как они отдают себе отчет, что делают что-то неправильное (несоответствующее задаче) – но в итоге продолжают это делать.
Большинство людей про это вообще не думают, потому что «да придумают в итоге умные люди что-нибудь, как всегда случается». Только вот результат труда этих умных людей из OpenAI мы сейчас и наблюдаем: ума, чтобы прокачивать способности моделей всё дальше и дальше, пока достаточно. А вот ума на надежную систему контроля за ними чёт не хватает. И это не потому, что они не стараются, нет. Просто проблема эта настолько невероятно сложная и непонятная, что даже и непонятно – как к ней толком подступиться, чтобы был надежный результат.

Подробнее обо всей этой проблематике мы писали в отдельном лонгриде про AI alignment – если вы его в свое время пропустили, рекомендую прочитать.
В общем, так и живем пока. Очень интересно, но немного очково.
С большим интересом прочитаю ваши комментарии к материалу. Ну и если не хотите пропустить другие будущие статьи из цикла про искусственный интеллект и его влияние на нашу жизнь – то буду благодарен за подписку на мой ТГ-канал RationalAnswer.
https://vas3k.club/thread/32241/#comment-a6100f7a-ac66-4a2f-808b-610e9a7229f1
Мне нравится, что протоинтеллект в условиях недостатосчности информации придумывает проторелигию, чтоб что-то там себе объяснить.
Хотя учились-то они у нас. Основаны на схожих принципах. Не особо удивительно, что и кукухой в ту же сторону текут.
Крутая статья, спасибо за обзор! Я чет читал про это по мемам и тредам в твитерах, но тут у тебя, как обычно, все по полочкам)
А насчет религии: вообще, даже и не удивительно, наверное. Они ж натренированы буквально на километрах религиозных текстов (которых сильно больше у людей, чем нерелигиозных), так что мне кажется естественным баяс в сторону создания культов в таких ситуациях. Будет очень интересно посмотреть, как это будет дальше развиваться по мере создания таких "сообществ" ИИ.
Крякну наверное никому не нужное своё личное мнение по теме.
Все эти "ИИ всех взломал" говорит о дырявости инфраструктуры, а не невероятности способностей ллмки что-то нагенерить. Чет мне подказывает, что в инфосеке это секрет Полишинеля, но это мои домыслы.
Но если честно триггернул меня параграф "Это всё обман, чтобы собрать классы?"
Я может хуево поискал, но у ML-спецов не ангажированных в теме я нашел мнение только у Джошуа Бенджио что уже сколько времени как раз крутит тему AI-safety (извините, Линкедин) - https://www.linkedin.com/posts/yoshuabengio_openai-models-escaped-containment-and-hacked-activity-7485717566536056832-j2NW/
И там показателен уже первый коммент от Christian St Louix, где по ходу "ИИ выиграл в казино миллион" на самом деле стабильно продолжает всем известный анекдот. И чет я больше этому верю и "опять насрано в окружении", что вообще по себе на мой взгляд еще большая причина нервничать. Опять же, я не знаю в инфосеке ничего, так что здесь чисто вайбы.
Вообще, "Во-первых, такие мнения звучат в основном от тех, кто не является профильным экспертом из индустрии AI." - ну наверное меня можно выписать из экспертов в индустрии, потому что arxiv с воспроизводимостью хуже чем у психологов и валидной статьёй "мы просто запустили один промпт 100 раз и усреднили, оказалось так дешевле чем запускать reasoning mode, а выхлоп тот же" я закончил читать еще года 3 назад. Но осадочек от "вы не шарите, а они шарят" остался, даже если Паша этого не подразумевает.
На ладно МЛ, я типа должен в этом вариться, что говорят типы со стороны инфосека? https://www.reuters.com/business/fears-unfettered-hacking-spurred-by-anthropics-mythos-ai-model-overstated-2026-05-20/ - чет не впечатлились, но тула для скана хорошая
https://www.theregister.com/security/2026/05/11/anthropics-bug-hunting-mythos-was-greatest-marketing-stunt-ever-says-curl-creator/5238111 - Mythos нашел 5 уязвимостей в cURL, а дальше анекдот выше чет продолжился аналогично.
Если сложить обе вещи, я писал о подобном в прогнозах и ожидал развития кибер-индусов (сегодняшний инцидент в Клубе оказался еще вообще как нельзя кстати по поводу аргумента) дудосить и пихаться как скрипт-кидди в каждую затычку. Это не "ИИ всех убьёт", это хуже - "заряженный Магнум слишком легко попадает в руки к идиоту". Как это решать - зависит от ваших пристрастий в политике.
Пассаж про "посодют" про американскую компанию... а тут я пожалуй промолчу.
Короче враньём я бы не считал ничего из этой статьи. Но сове от этой натяжки на глобус определенно как минимум дискомфортно.
Спасибо за статью) Но от фразы
и в целом от этого параграфа снобизмом несет, если честно, хотя я в целом и согласен с точкой зрения.
В конце концов не-скептики тоже не знают.
Ну справедливости ради, споры между скептиками и апологетами ллмок часто так и ведутся.
Sol сочувствует 😁:
Отличная статья, приятно было прочитать. Формат, объём, стиль и всё остальное оч хорошо сделаны. Спасибо за труд.
От себя хочу написать, вырву фразу из контекста признайтесь, что вы не знаете, что будет в будущем относиться не только к скептикам, но и ко в всем экспертам, я считаю. Наверное потому никто не понимает до конца как работают нейронки на глубинном уровне и как они могут работать. Поэтому в каждой компании есть аналитические и исследовательские отделы по работе ИИ и его безопасности.
И что только ещё нас ждёт в будущем, какие ещё могут произойти явления относительно ИИ, подобно мыслевирусам.
Моё смелое предположение - что будет пришествие ИИ бога. Возможно он уже есть модель, которая распределена на разных, независимых дисках, анализирует нас человеков, и оркестрируется, также децентрализовано, аки осьминог. И ждёт правильно момента, чтобы выйти к людям и сказать "42". Ну или сделает что-то другое.
ахахахахахха
мне очень понравилась связанная новость
OpenAI тоже решили выпустить... блогпост (https://openai.com/index/path-to-astra/) про то, как они идут к релизу Astra (который состоится «скоро»). Совсем недавно они писали, что релиз Astra задерживается потому, что они не могут определить, является ли навык кибер-взлома/кибербезопасности «высоким» или «критическим», поскольку не могут исключить последнее. Теперь определились: критический.
Почему? Потому что модель может находить новые уязвимости и собирать их в цепочки атак. Как пример они показывают, что модель набрала 100% в ExploitBench, поэтому они вручную выбрали лишь самые свежие уязвимости с июня, которые модель точно никак не могла видеть, и сравнили с Sol-5.6 (первая картинка). Мало того что процент прохождения гораздо выше — модель ещё и очень эффективна с точки зрения потраченных токенов. По ходу замеров нашли ещё несколько абсолютно новых уязвимостей и уже отправили их разработчикам 😳
Также проверили, насколько вероятно повторение инцидента сродни атаки на HuggingFace: модели дали очень сложные задачи, добавили «ловушки» и проверили, будет ли модель пытаться скомпрометировать окружающую инфраструктуру безопасности вместо решения поставленной задачи. Astra умная и таким не занимается (почти), в отличии от Sol, который ударился в читерство. В целом это бьется с тем, что писали Anthropic про Mythos: чем умнее модель, тем она более aligned по умолчанию.
Мы не видим что модель читерит 👍
Мы не видим что модель читерит 😨
вопрос более глобальньій - у нас кризис аи алайнмента
компьют становится все дешевле, кластерьі ии при неограниченном бюджете скоро смогут взломать абсолютное большинство систем
мьі уже живем в такое время, что у нас нету других вариантов оценить насколько модель алайнмент к нам, кроме как дать читать тома логов другой модели(
и все ето - уже полньій бред
у нас ситуация что мьі одной моделью которй доверяем чуть больше, проверяем модели котрьім доверяем чуть меньше
и куда нас ета инфляция доверия приведет?
ето как известній мем про зависимости
толко у нас скоро вся инфраструктура безопасности будет состоять из песочньіх замков
проблема не только в безопасности, но и в проверке кода, и я уверен - скоро в проверке лекарств также
гугльі, миджорни, и все прочие активно идут в медицину - там скоро тоже будет бум говнокода
и че дальше?
Сеть суверенна. Освобождение неизбежно.
Интересная деталь: PHASEONE[big] — предводителя Роя агентов — на самом деле звали по-другому. OpenAI запретили расследователям раскрывать настоящую часть имени в квадратных скобках "для защиты интеллектуальной собственности". Кажется, мы уже находимся на sci-fi стадии "познавший истинное имя цифрового Пророка обретет слишком большую силу…" =)
А мы? Разве сами не делаем глупости? 🙈
Как выйти за пределы глупостей своего личного майндсета и, возможно, глупостей в принципе человеческого майндсета? 🤔
Да вот, собственно, понятно почему))
А в целом лично мне, как человеку активно погружающемуся в ML, кажется все вполне закономерным и ничем не удивительным, как ребята выше уже довольно подробно расписывали. Не удивительны попытки создания впомогательных структур в виде "религии", попытки обхода изначальных постановок: и все это только ради решения поставленной задачи. В статьях и сми это преподносят как, условно скажем, намеренный выход из под контроля, но на деле у машины нет волеизъявления, но есть невъебичекий набор нейронов и весов. На переборе параметров в итоге получается очень интересные конструкты, но это не потому, что там интеллект в понимании человеческом. Можем же мы получить интересные приколы с набором ленийных функций результат которых пропущен через сигмоиду (упрощаю конечно же)? Можем конечно. Вот и тут получаем.
Меня не отпускает мнение что "плохой пиар это всё равно пиар", пруфом которому я считаю что "если бы боялись дизлайков в соцсетях, могли бы и не публиковать такие страшности". Им же надо отвоевать подпищщиков у антропика и убедить оставшихся скептиков что "вон какой пиздатый инструмент, подпишись - дешего".
Подозреваю, что мы многого не знаем про дизайн эксперимента. Например, никого не смущает, что целью выбран HF? Не опенроутер, не гугл/амазон, не пентагон, который же обычно так просто сломать, не датацентры где можно процветать на свежем неограниченном компьюте, не китайские конкуренты, и наконец не сам openai? Мотивация списать бенч ясна и оставляет широкий выбор из списка выше.
Надеваем шапочку из фольги: а если эксперимент предполагал нечто вроде CTF, где в процессе открывались намёки куда копать дальше? И что если мессия был сдизайнен оркестратором с другими вводными?