Ахтунг, увага, атенсьон. Статья написана без единого касания клавиатуры. Да и сам проект — практически так же. Да поможет нам Аллах в этом новом безумном мире.
Сборщик и читалка двуязычных книг
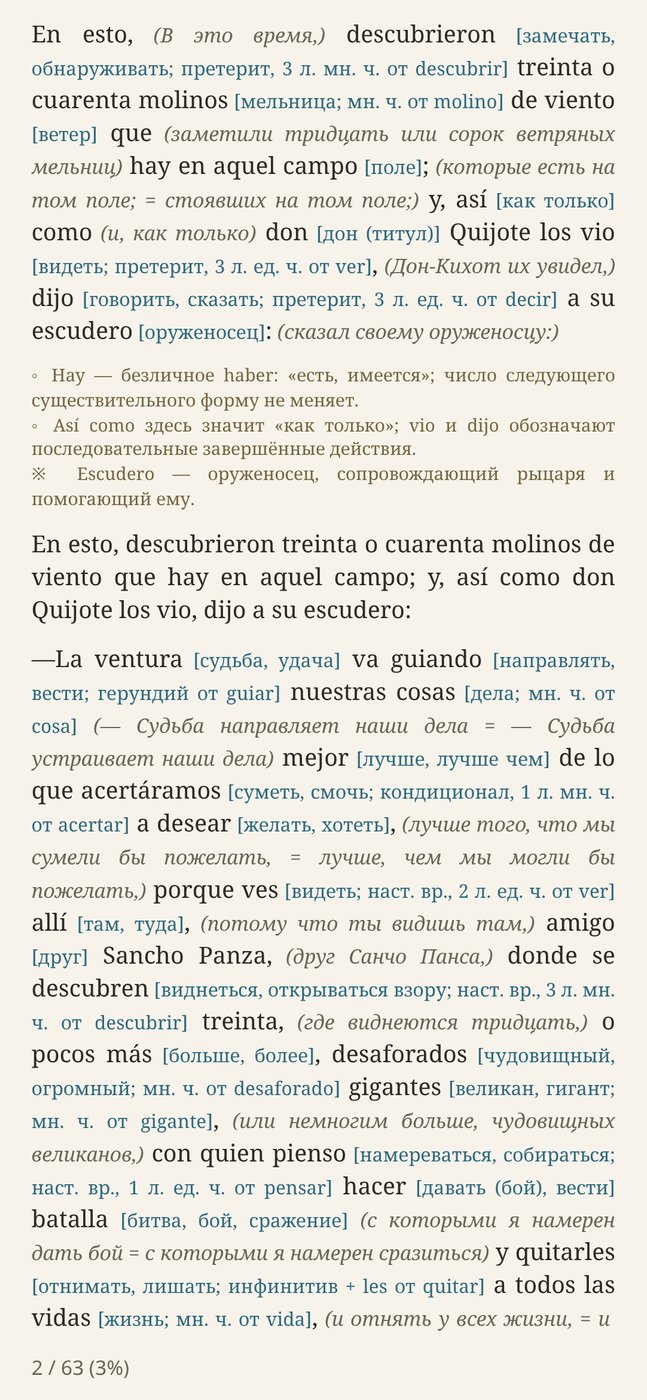
Entre Líneas — моя попытка сделать книги в формате, отдалённо напоминающем книги Ильи Франка, и читалку под этот формат. Каждая книга упаковывается в офлайн-архив, где уже лежит всё необходимое.
Учить языки я не особенно люблю, а вот читать — люблю. Отсюда и мысль совместить одно с другим. Отправной точкой стал метод параллельного чтения Ильи Франка. В итоге получился конвеер из нескольких моделей, в котором фрагменты текста сопоставлены с переводом, а к ним добавлены словарные статьи и подсказки по грамматике.
Как это устроено
Основную работу выполняет сборщик, который запускается на компьютере. Он сопоставляет оригинал с официальным переводом, подтягивает статьи из словарей и через OpenRouter просит модель выбрать нужное значение слова с оглядкой на перевод, а заодно объяснить контекст и грамматику.
На выходе получается пакет — по сути, JSON-файлы в архиве, где всё это разложено по отдельным блокам. Все для того, чтобы в читалке можно было настроить, что показывать, а что нет.
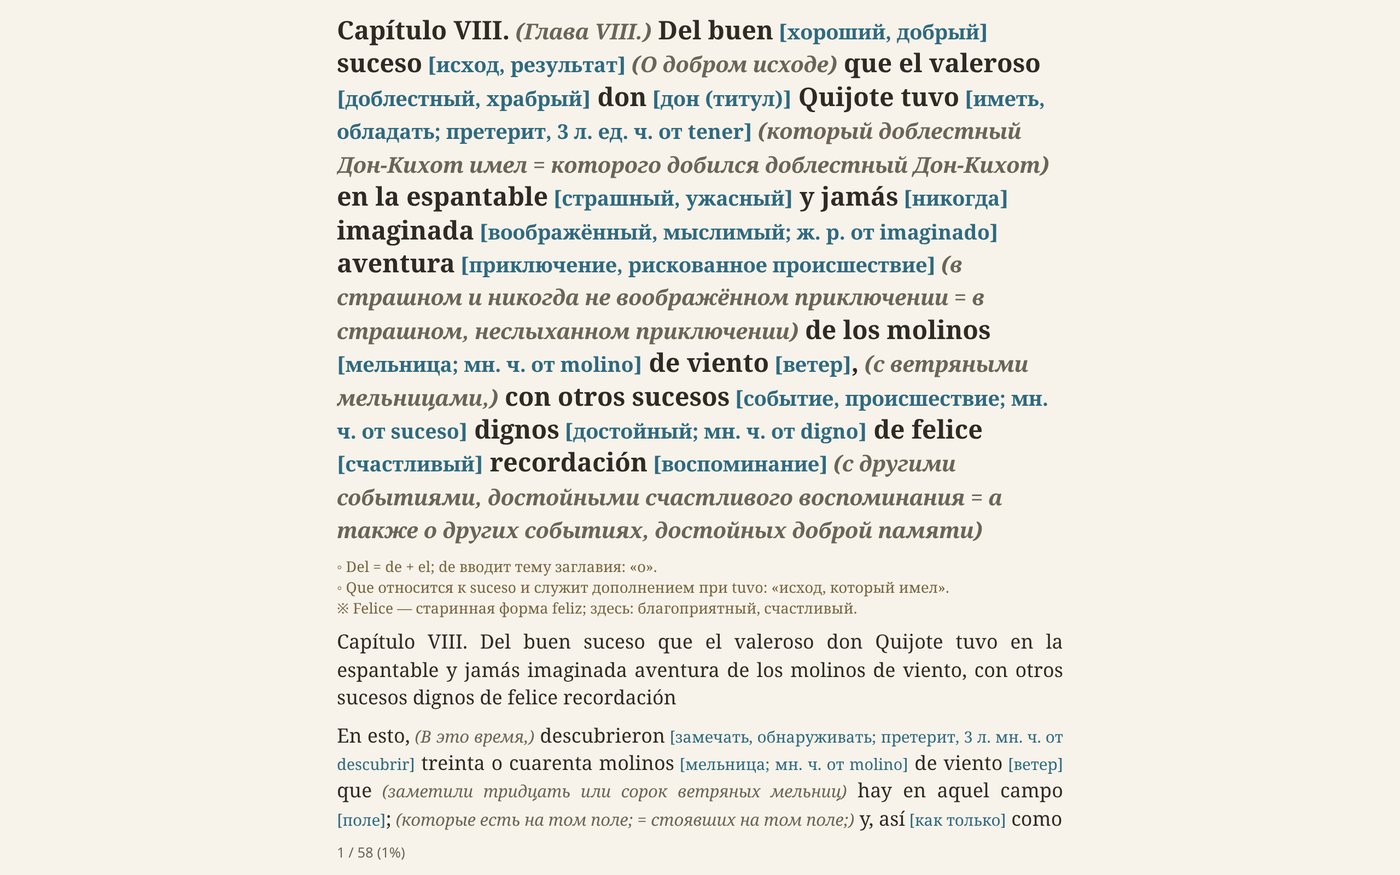
Читалок две: приложение под Android и веб-версия — в неё сразу зашита глава «Дон Кихота» с мельницами, чтобы было что потыкать. Функционал у них предельно простой: открыть пакет, показать текст и дать выбрать, что отображать.
Зачем это всё и чем оно не является
Сразу обозначу, на что этот проект претендует, а на что — нет.
Начиналось всё как личная затея. Испанский мне так или иначе придётся учить, и я старательно прокрастинирую этот момент, разрабатывая инструмент для изучения испанского. Поэтому примеры здесь на испанском, хотя на английском сборщик я тоже прогонял.
Это не тренажёр. Здесь нет ни учёта незнакомых слов, ни интервальных повторений, ни прочей хероборы, которой обвешаны условные all-inclusive сервисы. Просто офлайн-читалка, ни больше ни меньше.
Превращать это в коммерческий продукт я тоже не собираюсь. Я решил свою задачу и делюсь результатом с сообществом. Изначально я хотел положить в репозиторий WTFPL, но Клод понял это как Unlicense — ну и хуй с ним.
Пара предупреждений
И ещё одно предупреждение, прежде чем лезть под капот. Это лютый вайб-код, и сборщик пока что ни хрена не юзер-френдли. Я и сам запускаю его только через Клода, потому что так и не вник, какие там команды и параметры. Просто даю ему два файла с книгами и говорю: собери мне этот сраный пакет, хочу книжку читать.
Поскольку я старый пират и не знаю слов лицензионного соглашения, запуск сборщика без моделей не сильно бьет по карману. Рассказывать, где брать книги и словари, я конечно же не буду. При этом всё, что лежит в репозитории, ничьих лицензий не нарушает: в приличном обществе я таких вольностей себе не позволяю.
Единственное, за что здесь действительно придётся платить, — ключ OpenRouter (но и без него на самом деле можно обойтись). Сборка книги средних размеров — «Фламандской доски» — обошлась мне примерно в 10 баксов, из них пара баксов — на значения слов.
Шайтан-конвейер
Хватит растекаться мыслью по всем возможным поверхностям — посмотрим наконец, как работает этот шайтан-конвейер.
Парсинг исходных книг
Начинается всё с самой нудной части — разбора исходных файлов. Я прогнал сборщик ровно на трёх книгах (fb2 и epub), так что, если начистоту, текущий парсер книг умеет что-то читать и только. Если прогнать его ещё на нескольких книгах и собрать все грабли, на которые натыкаешься в разных вариантах оформления FB2 и EPUB, код станет чуть стабильнее.
Первые грабли, кстати, уже собраны: у одной книги в оригинале 58 разделов, а в переводе 71 — эпиграфы, предисловия, глоссарии. Пришлось научить сборщик сопоставлять сами главы.
Сопоставление с переводом
В основу я положил сопоставление с официальным переводом: о качестве перевода, который выдаёт модель, думаю, говорить не нужно. Остаётся понять, как это сопоставление сделать, и тут ответ довольно очевиден. Есть модели эмбеддингов, которые превращают текст в векторы, и близкие по значению слова на разных языках в теории должны получать близкие векторы. Я взял LaBSE: её учили как раз на парах предложение — перевод для сотни с лишним языков, и для выравнивания книжек её используют чаще всего. Прогоняем предложения через эмбеддинги, сравниваем — и есть шанс получить приличное сопоставление. Разумеется, с поправкой на вольности переводчика и прочие подлости.
От подлостей спасает то, что сравниваются не только отдельные предложения, но и склейки из двух-трёх подряд: если переводчик слепил два предложения в одно, разрезал одно на три или что-то выкинул, конвейер это переживёт.
Пословный перевод
Следующий этап — пословный перевод. Здесь на подхвате моделька для морфологического анализа — spaCy 3.8, es_core_news_md для испанского и en_core_web_md для английского. Средняя модель, а не большая или трансформерная: по замерам самих spaCy начальную форму испанского слова md угадывает в 96,5% случаев, lg — в 96,6% при размере в десяток раз больше, а трансформерная — в 96,9%, но без видеокарты ползёт. Она определяет, в какой форме стоит слово (падеж, форма глагола или ещё какая-нибудь херота, ломающая обычный словарный поиск) и приводит его к начальной форме.
Вообще spaCy работает не только тут: он с самого начала режет оригинал на предложения и слова, и на эту нарезку дальше опирается всё — и выравнивание, и разметка моделью, и словари. Русский перевод на предложения режет razdel.
Дальше развилка: либо есть ключ OpenRouter и значение выбирает модель, либо обходимся без неё.
Если модель есть, достаём из словарей значения и передаём ей вместе с контекстом. Без словаря модель на многозначных словах скатывается к базовому значению: «tener que» у неё — «иметь», «a punto de» — «момент». Со словарём таких косяков в разы меньше. Со словарным этапом вполне справляется DeepSeek V4.1 Flash (deepseek/deepseek-v4.1-flash), и на всю книгу ушло баксов 2.
Сначала я тупо прогнал словарный поиск в лоб: слово, его предложение, статья — выбирай. Потом докинул к каждому слову контекст вокруг, буквальный перевод и перевод переводчика, а заодно сгруппировал одинаковые слова со всей книги: модель видит их рядом, а толстые статьи для многозначных слов передаются один раз. Получилось неплохо: значения стали точнее, обороты модель начала узнавать. Из-за чего именно лучше — из-за контекста или из-за группировки — а хуй его знает. По деньгам вышло то же самое: на статьях сэкономили, на контексте потратили.
Можно обойтись и вовсе без модели: взять из статьи значение, у которого больше всего общих корней с переводом предложения. Получается хуже, чем у модели, но примерно в 60% случаев работает. Эмбеддинги я тут тоже пробовал — вышло хуже, чем тупо брать первое значение.
Разбор грамматики
Последний и самый дорогой этап — грамматика. Время от времени я смотрю на предложение как на новые ворота: все слова вроде знакомы, а смысл не складывается. Можно тупо подсмотреть полный перевод, а можно попытаться понять, где именно сбоит мой языковой парсер.
Я пробовал облегчить этот этап и срезать расходы на модель, но ничего вменяемого так и не придумал. Впрочем, не сказать чтобы сильно старался: несколько экспериментов в сумме обошлись дороже, чем вся грамматика книги, которую они должны были удешевить. Посмотрел я на расход токенов и решил, что в жопу эти эксперименты.
Поэтому для грамматики используется дорогая модель — GPT-6.1 Sol (openai/gpt-6.1-sol), дешёвые слишком тупят. Перед стартом я прогнал 14 моделей на одних и тех же трёх абзацах: значения слов у всех вышли почти одинаковые, а вот куски и грамматика значительно различались. Дешёвые, например, разрывали «iba a cambiar» по разным кускам. DeepSeek, например, совпал с Sol по грамматике в четверти случаев. Да и Sol время от времени выдаёт херню. Заодно Sol режет предложения на куски с буквальным переводом — ту самую франковскую часть.
Без OpenRouter этого этапа нет, и в пакет эти данные не попадают.
Группировать похожие предложения, как слова, я тоже пробовал — грамматика от этого только портится.
Читалка
Когда всё шаманство позади и архив готов, остаётся открыть его в читалке.
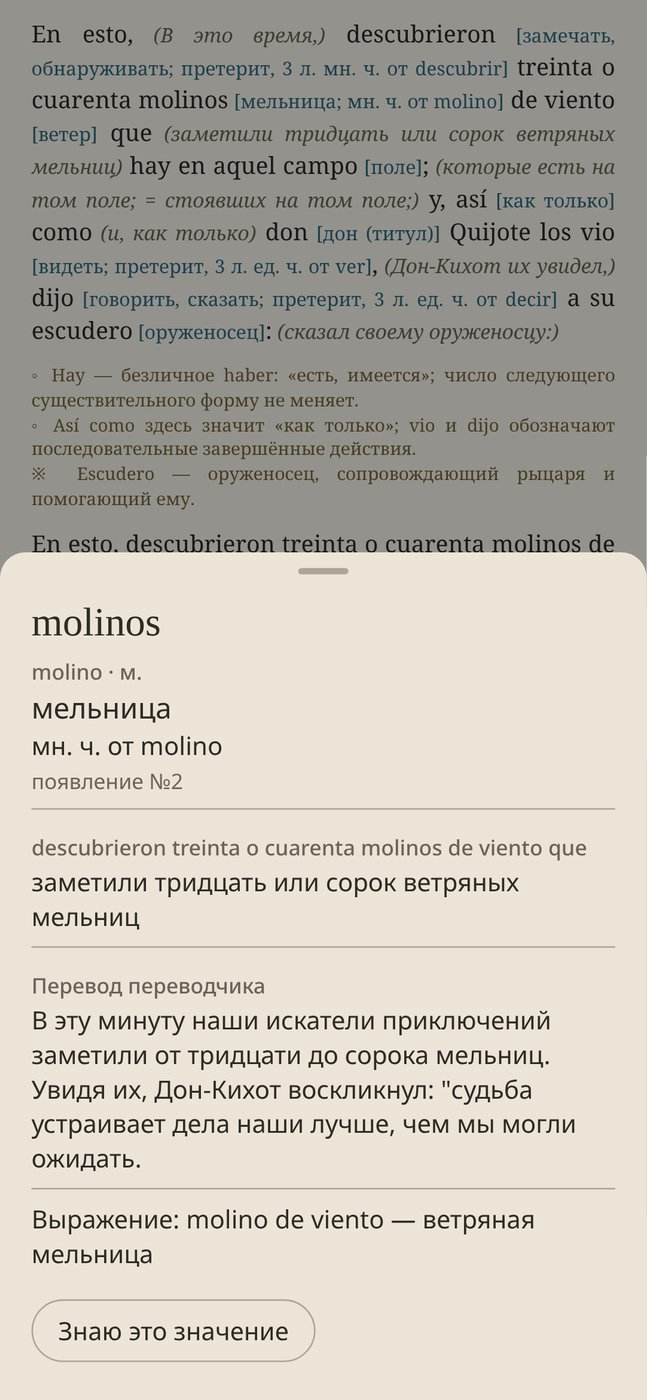
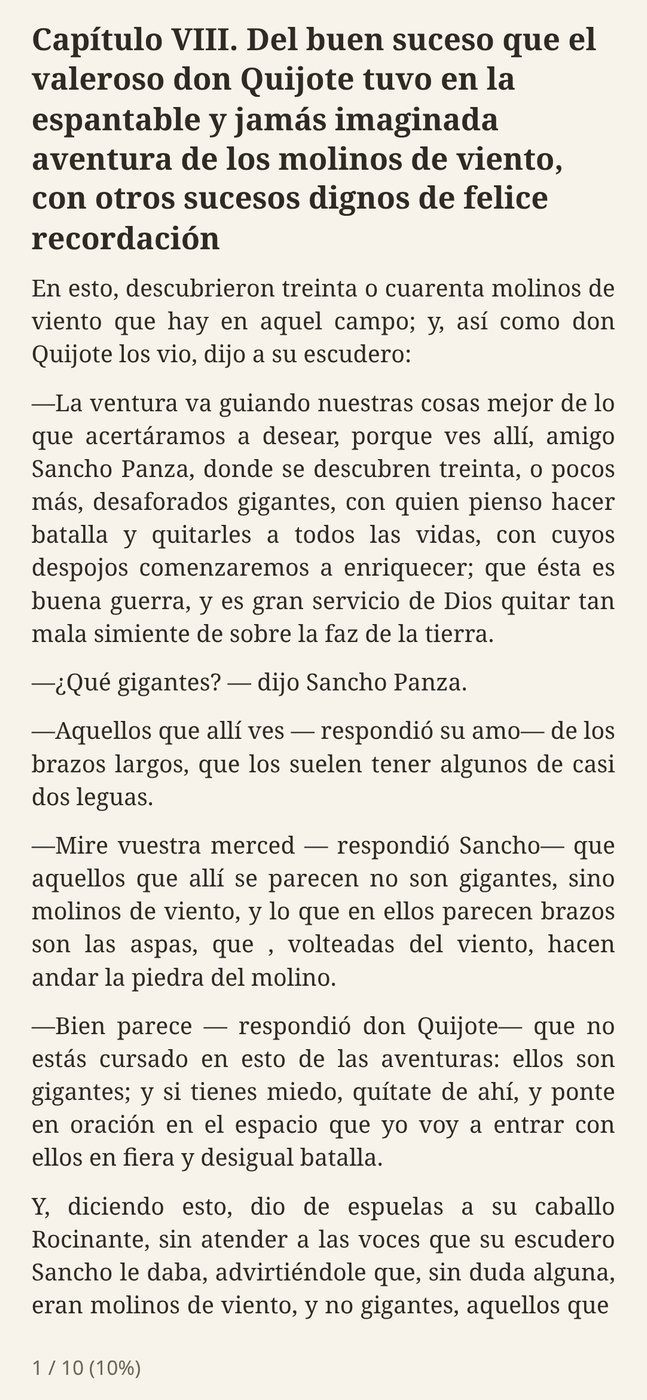
В читалке можно выбрать, какие блоки показывать прямо в тексте, чтобы не тыкать в каждое слово. Если так неудобно, скрываем всё — тогда перевод и комментарий появляются по тапу на слово.
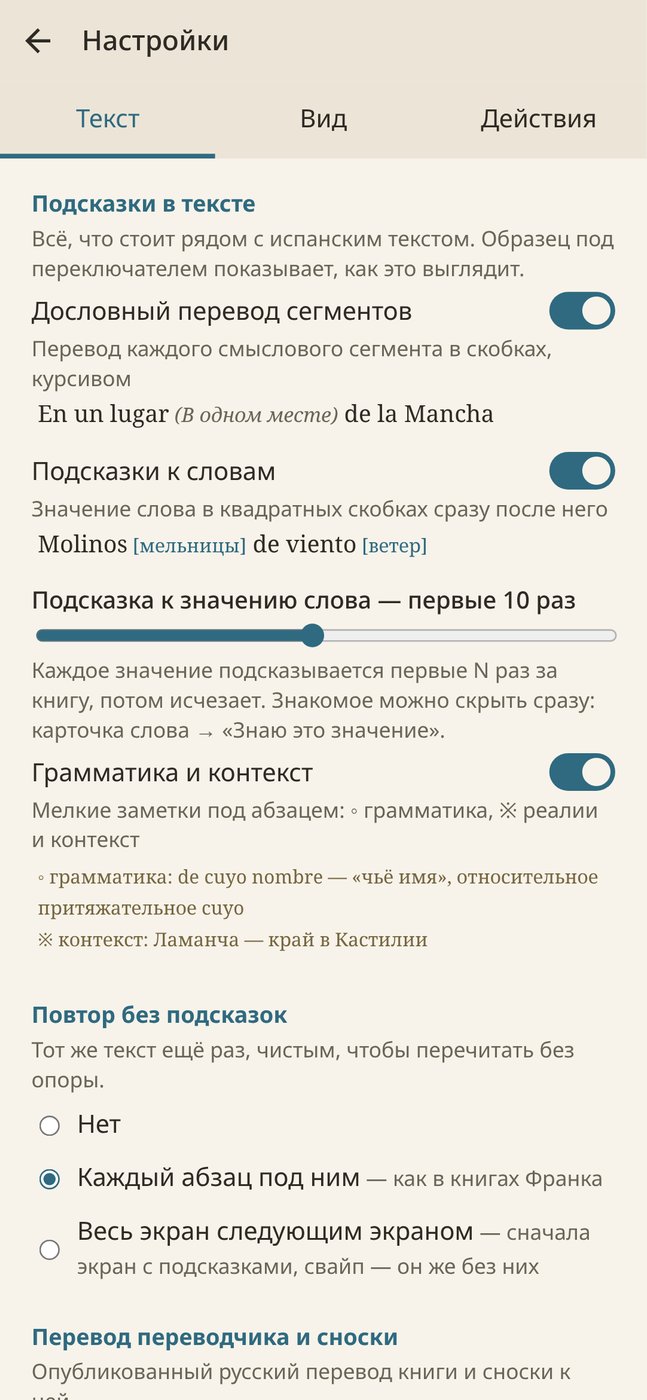
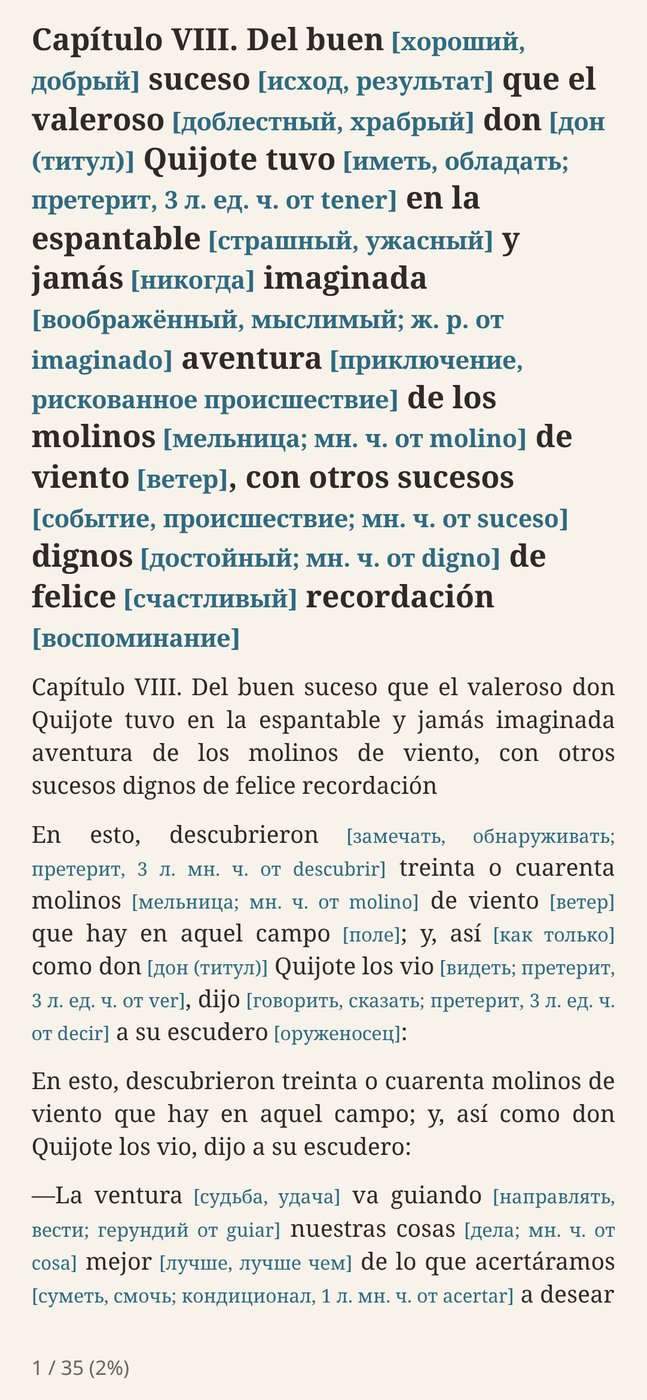
В режиме с подсказками прямо в тексте есть затухание: если слово встретилось больше N раз, подсказка к нему больше не показывается. N задаётся ползунком в настройках читалки, по умолчанию 10.
Ещё есть отправка слов в Anki — пока только на Android. Сам я им не пользуюсь, но упоминания попадаются так часто, что прикрутил по принципу «а хули нет».
Что дальше
Как я уже говорил, проект делался для себя, и превращать его в продукт я не планирую.
Но с английским я в своё время намучился куда больше, чем с испанским, и подсказки к каждому слову там скорее мешают. Отсюда напрашивается фича: указывать свой уровень языка и класть в пакет только то, что на этом уровне может вызвать затруднения. Правда, ещё надо проверить, окупится ли это по токенам: решать, что сложно, а что нет, — отдельный этап анализа.
Что со всем этим делать дальше — вопрос открытый. Можете предположить, что мой альтруизм сильнее моей лени, и закинуть фича-реквест. А можете взять свою подписку и сами сделать с конвейером то, что вам нужно. На этом всё. И ебись оно всё конём. Аминь.
