Дисклеймер: я разработчик а не ML researcher, поэтому фокус будет на практическом применении подобных моделей. Описание как работает под капотом тот же kev требует отдельной статьи, как мне кажется.
System One и System Two
Название System One происходит из книги Thinking, Fast and Slow, где описываются 2 системы нашего мышления:
- System One (Система 1) - быстрые, автоматические решения без особых усилий. К примеру - "посчитать 2+2", "прочитать текст на вывеске", "управлять машиной на пустом шоссе".
- System Two (Система 2) - медленные, вдумчивые решения требующие внимания и концентрации. К примеру - "перемножить два больших числа (1457*4568)", "посчитать количество букв 'A' на рекламном плакате", "сравнить 2 продукта по соотношению цена/качество".
Что такое System One модели
Допустим у нас есть система для саппорта которая разбирает письма от клиентов и решает несколько вопросов:
- Какая команда должна заняться проблемой из письма? (доставка/биллинг/возраты)
- Нужно ли вернуть клиенту деньги? (да/нет)
- Нужно ли эскалировать проблему? (да/нет)
- Насколько клиент недоволен (спокоен/недоволен/очень зол)
Обычно это реализуется с помощью дешевой LLM модели (Haiku/Luna/etc) которой задаем промпт. Мол, вот краткая выжимка письма, вот список команд - проанализируй и возвращай данные в заданном json формате. С таким подходом есть несколько проблем:
- Галлюцинации LLM может придумать несуществующую команду. LLM модели, особенно дешевые, могут галлюцинировать.
- Неправильные вероятности Можно попросить LLM оценить вероятность ответа ("биллинг, 90%") но это не будет являться той самой вероятностью с которой LLM выбрал этот вариант ответа.
- Стоимость и время Мы тратим впустую достаточно много токенов и времени чтобы генерировать json.
- Настройка модели При использовании закрытой модели чтобы подстоить модель под ваш домен придется задавать примеры в промпте, что раздувает контекст и увеличивает вероятность галлюцинаций (см. пункт 1).
В отличии от LLM, System one модели не генерируют текст. Они возвращают вероятности. В данной статье я буду рассматривать Jev (первая System one модель, закрытая) и Kev (самый популярный на данный момент open source аналог). Эти модели поддерживают 3 типа вопросов:
- choice Вопрос с несколькими вариантами ответа (до 255 вариантов)
- score Шкала с уровнями (от 2 до 10)
- noul Бинарный вопрос типа да/нет
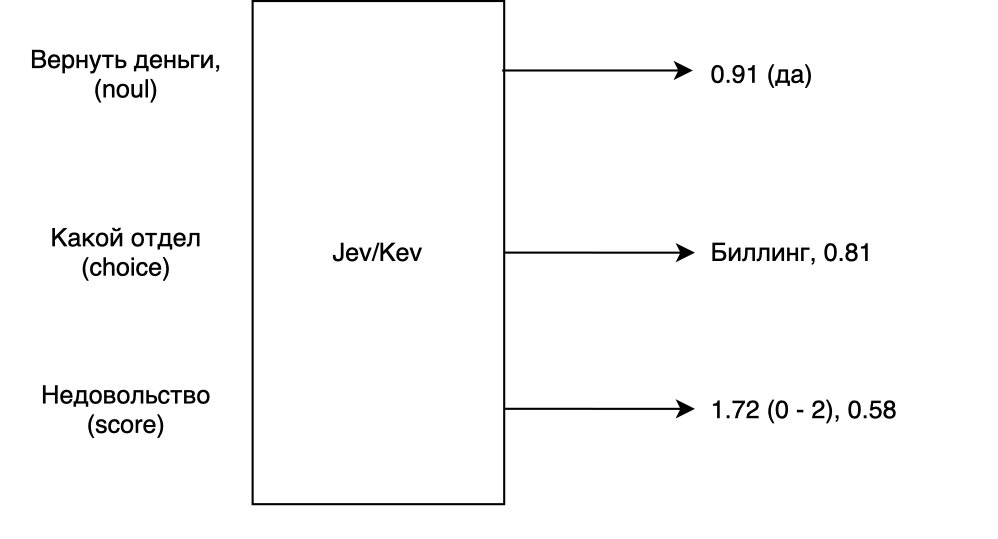
То есть для бинарных вопросов system one модель вернет вероятность ответа "да", для choice - вероятность каждого варианта ответа а для score - позицию на шкале и уверенность ответа (confidence).
Грубо говоря, system one модели это что-то вроде классификатора.
Пример
Вернемся к системе для службы поддержки из предыдущей части. Злой (spoiler alert) клиент пишет компании - мне списали деньги 2 раза, верните немедленно:
I have ordered shoes from you (order #123) and I've been charged 2 times for my order. I want my money back!
Задаем вопросы (questions):
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this?",
    "criteria": {
      "returns": "Exchanges, refunds, wrong or damaged items",
      "shipping": "Delivery status, delays, lost packages",
      "billing": "Charges, invoices, payment problems"
    }
  },
  "is_refund": {
    "type": "noul",
    "instructions": "Is customer eligible for refund?"
  },
  "escalate": {
    "type": "noul",
    "instructions": "Does this message require urgent human attention?"
  },
  "frustration": {
    "type": "score",
    "instructions": "How frustrated is the customer?",
    "criteria": [
      "Calm",
      "Frustrated",
      "Very angry"
    ]
  }
}
И получаем что-то вроде этого:
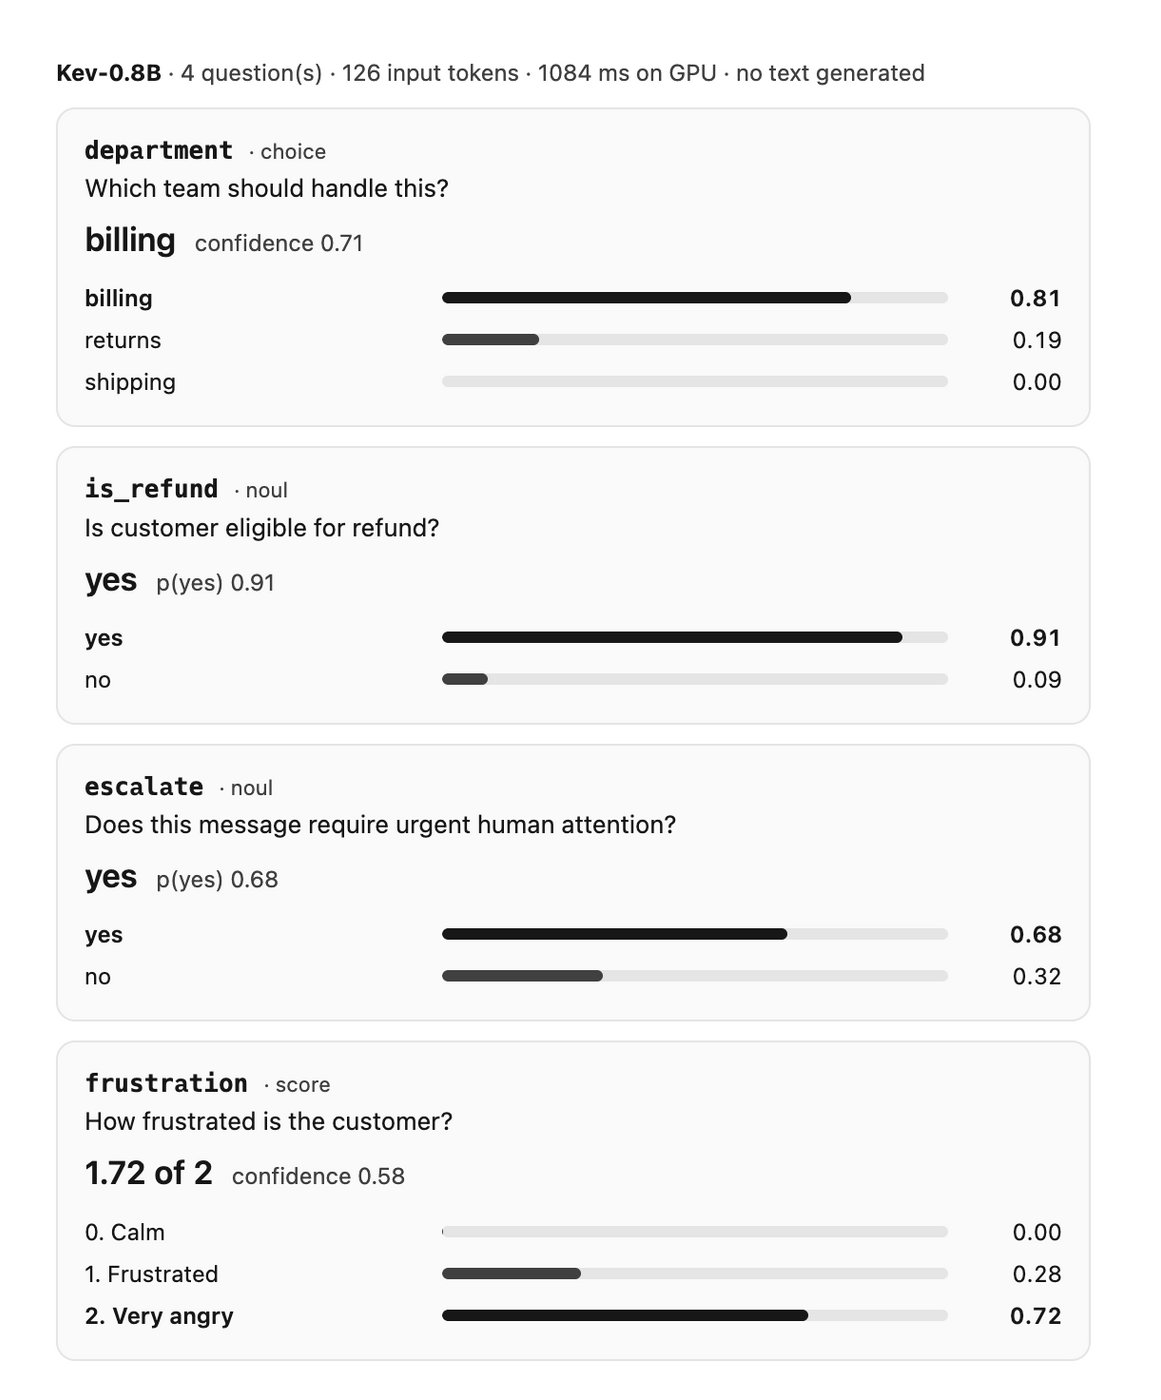
Пример должен работать и в Jev - API идентичный.
Можете поиграться сами на huggingface ну или запустить kev локально - инструкции в репозитории.
Self-hosted модели
Локальный запуск это хорошо, но что насчет продакшена? Обычно разговоры о целесообразности идеи хостить свою модель заканчиваются после взгляда на цены, где инстанс с GPU сразу дороже обычного минимум в 2-3 раза. Тут хорошая новость - kev может работать без GPU (запускаем с --device cpu). Горячие запросы на инстансе с 16 GB RAM и 4 vCPU занимают 1-3 секунды, что вполне приемлемо для многих кейсов.
Дополнительные материалы
OpenAI тоже подсуетились
P.S. Данный текст писал человек. Текст не причесывал, стиль авторский. Надеюсь кому-нибудь пригодится!
Класс, спасибо за KEV! Всё хотел загуглить если Open-Source JEV, а он даже на CPU работает.
Юзаю JEV для личного бота: кидаю ему голосовую заметку, он классифицирует. Если классифицировал в «заметка по проекту», то второй JEV классифицирует по какому из проектов и т.п. Очень быстро, очень дёшево, точно. Радует, что есть альтернативы LLM, потому что их применение буквально для всего кажется перебором.
Спасибо за практическое введение!
Забавно как индустрия в очередной раз перепридумывает термин, у Канемана System One именно что генерировала ассоциации, выдумывая в том числе несуществующие связи.
У меня буквально пара замечаний по технической части:
Kev -- это та же LLM (Qwen какой-то), только без авторегрессионной генерации ответа.
Галлюцинации очень даже возможны в формате выбора ответа из априорных знаний модели, без использования текущего входа/инструкций
С вероятностями все тоже не тривиально, это не настоящие вероятности, хоть на тестах выглядят хорошо. В смысле не надо использовать эти скоры для каких-нибудь байесовских вычислений как есть 😅