
Интро
Всем добра!
Меня зовут Марк, и я РПшу с ИИ уже 3й год. (Это не интервенция, честно)
ИИ развивается очень быстро, и компании делают все, чтобы опыт общения с ними был настолько прост насколько это вообще возможно. Все сделано для того, чтобы привести вас на экран оплаты чата как можно быстрее. Ведь вы — это продукт. Ваши переписки, ваши документы, ваши данные это то, на чем следующее поколение моделей уже тренируется. Но… Может быть облачный ИИ это не единственный путь? Что, если можно общаться с искусственным интеллектом на своем устройстве, не давая никому свои переписки? Это те самые вопросы, которыми я задавался, пока смотрел на развитие ChatGPT в ковидные времена. Тема мне казалась очень сложной, и я старался особо про нее не думать… Пока в 2024м году я не разочаровался в ролеплее с людьми (в очередной раз), и не пошел искать альтернативы.
Поиски привели меня в character.ai, где я обплевался, но не мог не заметить потенциал искусственного партнера. Порыскав по сети еще немного, я наткнулся на небольшое, но очень быстрорастущее коммьюнити людей, которые брали коммерческие модели, выпиливали из них отказы и цензуру, и перетренировывали на своих, РПшных датасетах. Причем модели были вполне себе небольшие. «Ну они точно не могут быть хорошими» — подумал я, но все равно попробовал. И результат был… На тот момент мозговзрывающим, особенно после опыта с Character.ai. Модель двигала историю, не запиналась, не уходила в петлю, оставалась в персонаже и помнила про особенности. Конечно, было не без проблем — все относительно быстро скатывалось в повторение, контекст заканчивался. Но даже при всех минусах, даже тогда это было обалденно. И с тех пор модели только улучшались, и оптимизировались под потребительское железо. То, что мы имеем сейчас значительно превосходит то, с чем я начинал.
Эта статья — это рефлексия на те времена, и написана она для меня же. Того меня, который барахтался в непонятных терминах, концептах, и инструкциях которые были либо очень поверхностные (скачай ollama), или уходили в дебри настройки бэкэндов через командную строку. Простой и понятной инструкции настройки ИИ для РП, с описанием основных терминов я не нашел. Поэтому решил написать сам. Ориентировано это на тех, кто хотя бы немного шарит в технологиях, и комфортно чувствует себя за своим компьютером. Моя цель не просто расписать шаги, а объяснить логику того, как это работает, чтобы после прочтения вы могли узнать модель по названию, прикинуть влезет ли она, и устраивает ли вас.
ДИСКЛЕЙМЕР!
Во первых — чтобы поднять хоть какой то рабочий ИИ дома, надо иметь как минимум 12гб видеопамяти на обычном компьютере, или примерно столько же shared memory на apple silicon. Особо маленькие модели существуют. Но качество пока что плаченое.
Во вторых — я пришел из бэкграунда ИИ РП, и видел насколько опасно это может быть. Я понимаю, что звучит глупо, но многие, особенно получая в первый раз возможность общаться со своим любимым персонажем в приватном, локальном сеттинге, теряли голову, и уходили в этот РП целиком. Люди дома закладывали, чтобы купить больше видюх. Будьте осторожны.
В третьих — подавляющее большинство моделей тренируется на английских датасетах, соответственно с другими языками у них могут быть проблемы.
И еще, наверное, стоит объяснить, что такое РП для нормальных не шарящих.
Ролеплей (от англ. roleplay, также встречается сокращение RP — roleplaying) — это форма интерактивного повествования, в которой участники не действуют от собственного лица, а отыгрывают вымышленных персонажей. Их решения, диалоги и поступки формируют коллективную историю в рамках определённого сеттинга (вымышленного мира).
Если простыми словами — то это отыгрывание роли какого либо персонажа. Есть те, кто наряжается в средневековых рыцарей, и устраивает поединки. Есть DnD. Но в данном контексте это когда вы придумываете себе персонажа, находите такого же ебанутого увлеченного, и отыгрываете вместе какую либо историю\приключение, обычно по очереди — одно сообщение за раз. Соответственно с развитием ИИ мы получили возможность исключить из этогй кринджовой активности второго человека, и заменить его роботом.
Терминология
AI (ИИ). Общий термин для систем, которые принимают решения на основе алгоритма. Это может быть как НПС в старой игре, написанный на блоках
if() else(), так и современной мультимодальной LLM моделью от OpenAI. В этой статье я буду использовать этот термин для описания готовой системы, которая берет запрос от человека, обрабатывает его, и генерирует ответ, либо действие. Современные ИИ это сложные математические конструкции, которые лучше всего работают, используя мощности современных графических ускорителей (видеокарт), и загружаясь в видеопамять. Однако иногда этим можно пренебречь, и использовать оперативную память (очень сильно жертвуя скоростью), об этом ниже.
Model (Модель) — Модель, это «мозг» современного ИИ. Это именно то, через что проходят все запросы, и где хранятся все данные. Не вдаваясь в математические подробности — это набор «слоев» из искусственных нейронов, и алгоритмов обработки вводных данных. Модели бывают самые разные, от архитектуры до датасетов (об этом чуть позже). Некоторые созданы для обработки и генерации текста, другие для изображений, третьи для звука и тд. Стоит упомянуть термин LLM — Large Language Model. Термин очень распространенный, и им называют как раз те модели, которые так или иначе работают с текстом. Сегодня самые популярные — это мультимодальные LLM — модели, которые умеют работать сразу с несколькими видами вводных данных. К примеру - брать картинку, анализировать ее, и генерировать на ее основе текст. Если интересно более техническое описание — у IBM есть неплохая статья.
Тут же хотелось бы сделать ремарочку по поводу вводных данных. Просто закинуть картинку в чат не получится, потому что сама текстовая модель, даже мультимодальная не знает что с этим делать. Для того, чтобы обработать это дело, модели нужна небольшая (обычно меньше гигабайта) «подмодель» — mmproj (MultiModal Projector), которая обработает картинку\аудио и «переведет» ее на язык нашей LLM. Для каждой модели, и для каждого типа данных этот mmproj файл свой, и обычно лежит в репозитории с ней. То есть впихнуть mmproj файл от Gemma в Qwen не получится.
Dataset (Датасет) — Датасет, это огромное количество данных, отсортированных особым образом, и подготовленных для обучения ИИ. Выглядит это обычно так: «Человек: Сколько будет 2+2? Ассистент: 4». Крайне упрощенный пример, но суть именно такая — модели дают пример того, как надо делать, и она на его основе учится. Хороший, чистый датасет влияет на итоговую модель чуть ли не больше, чем все остальные, технические детали. И соответственно плохой датасет может убить технически хорошую модель.
Parameters (параметры) — Базовый «размер» модели. Параметры — это перманентные настройки, которые модель «учит» из датасета. Чем больше параметров — тем умнее модель, и тем больше она знает. Измеряется обычно в миллиардах, и указывается после названия модели, например Gemma4_31B — 31 Миллиард (Billion) параметров. Она будет значительно умнее, чем Gemma4_9B.
Quantization (Квантизация). Oh boy… Это тот самый топик, который вызывал у меня больше всего вопросов и проблем. Про Квантизацию написано огромное количество технических статей (одна из лучших, на мой взгляд, это статья от geeksforgeeks), но тут я хотел бы подойти к этому с самого простого угла. Лучшая аналогия, которую я смог придумать — это jpeg. Вы берете огромную, красивую фотографию, которая весит 50мб, и сжимаете ее, выкидывая данные, которыми можно пожертвовать, чтобы снизить вес. Чем меньше вес, тем больше артефактов и тем меньше деталей, и тут уже каждый выбирает оптимальное соотношение для себя. Зачем нам 4к, если открываться фотография будет только на экранчиках смартфонов?
Примерно то же самое и здесь. У моделей есть «веса», которые определяют точность генерации. Это как уровень детализации на фото. У «оригинала» эти веса очень точные, и обозначаются 16-ти битными числами, но весят они непропорционально много, да и такая точность для рутинных задач не нужна. Поэтому их обычно сжимают, уменьшая эти самые числа. То есть, если брать очень грубо — Q8 это 8 бит от оригинальных 16. Q4 это, соответственно, 4. (В реальности это несколько сложнее, но опять же, статья не про конкретные цифры). К этой теме я вернусь еще на выборе модели, но тут важно просто понять сам принцип — мы теряем точность ради места.
Еще стоит добавить про типы квантизации. Они указываются в конце файла в формате~_K_Sили~_K_M. Они описывают агрессивность метода, и означают то же самое, что и буквы на одежде — S = small, M = medium, L = large. На практике, M и L мало чем отличаются, так что выбирайте исходя из возможностей. Полное имя файла выглядит НазваниеМодели_КоличествоПараметров_Квант_тип. Например Gemma4_27B_Q4_K_L.gguf
GGUF. gguf это формат файла, в котором распространяются квантизированные модели. Этот файл загружается напрямую в бэкэнд. Форматов более чем один, есть еще safetensors, exl2 и пр., однако в локальном сеттинге именно gguf получил большое распространение, за счет способности выгружать часть слоев модели в оперативную память.
Layers offloading (выгрузка слоев). Очень важный концепт в локальном ИИ. Тот, благодаря которому можно запускать модели, которые не вмещаются в VRAM. Происходит это следующим образом — бэкэнд загружает в VRAM все, что туда помещается. А все, что не помещается — выгружается в RAM. ОДНАКО! Если хотя бы один слой выгружается в RAM — скорость генерации падает в 5 — 10 раз! В РП ради хорошего ответа можно потерпеть. Однако если нужно писать код, или работать с агентом в цепочке — стоит подобрать что то, что поместится в VRAM целиком.
Context (Контекст). Контекст — это кратковременная память модели. В контексте хранится история переписки, а сам контекст выгружается в память вместе с моделью. Контекст измеряется в токенах, и для комфортной ежедневной переписки стоит иметь хотя бы 16к (16384), что примерно переводится в ~12 000 английских слов. Хотя сейчас стандартом является 64к (65536), который хранит в себе примерно 49 000 английских слов. Если диалог выходит за пределы контекста, модель начинает «забывать» что было сказано, и может начать повторяться, а иногда и галлюцинировать.
Token (Токен). Токен это текстовая единица, которой измеряется контекст и скорость генерации. 1 токен ≈ 0.75 слова. Стоит помнить, что код, и слова на языках, отличных от английского стоят больше.
Backend (Бэкэнд). Backend это программа, которая загружает модель, и работает с ней. А так же соединяет ее с…
Frontend (Фронтэнд). Собственно, чат. Зачастую эти два приложения объединены в одно для удобства, но для себя важно понимать, что логически это два разных компонента.
Выбор модели
Ну вот вы и решили, что хотите своего личного ИИ. Но вот какую модель выбрать? Дилемма.
Начать стоит с понимания того, что вы хотите, и сколько у вас видеопамяти. Основное правило — чем больше у модели параметров (B), тем она умнее. Однако чем ниже квант (Q), тем больше мы теряем в точности. То есть, Gemma 4 31B Q4 будет лучше в человеческом языке, будет лучше вас понимать, и писать более развернутые и креативные ответы. Тогда как Qwen3.8 9B Q8 будет давать сухие ответы, но будет намного точнее в генерации кода, математике, и будет допускать значительно меньше ошибок. Отсюда можно сделать вывод, что если вы хотите ролеплей, и готовы терпеть некоторые ошибки ради общего интеллекта, то стоит выбрать модель с бОльшим количеством параметров, даже если квант будет ниже. Однако если нужны точные вычисления и способность модели сохранять эту точность через цепочку мыслей — стоит взять более стабильную модель (выше Q), пускай и меньше по параметрам.
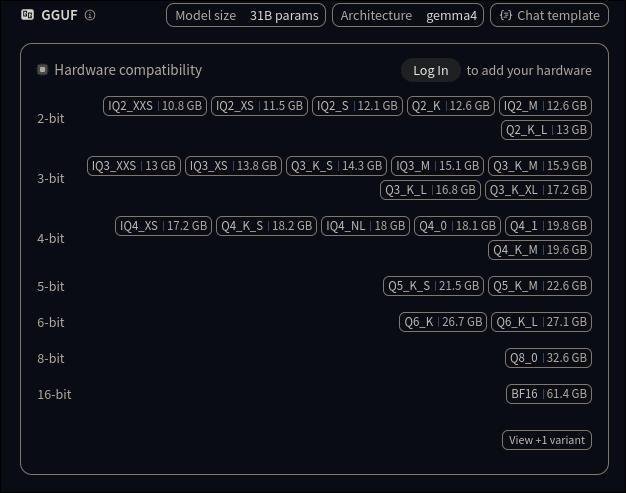
БОЛЬШИЕ МОДЕЛИ СЖИМАЮТСЯ ЛУЧШЕ! Это одна из тех вещей, которые мне нормально не объясняли долгое время. модель на 31B переживет квантизацию, и сохранит намного больше своей смышлености на Q4, чем 9B на Q6. Однако совсем маленькие кванты, типа Q2 уходят уже в категорию «copium», и практически бесполезны за исключением очень редких случаев. К счастью, HuggingFace, который является главным репозиторием моделей, очень удобно показывает примерный вес каждого кванта, так что можно примерно прикинуть, на что хватит вашего ПК. Стоит помнить, что надо оставлять 2-3гб на контекст, и хотя бы один гигабайт на всякие другие задачи (особенно если вы используете свою основную видеокарту).
Про цензуру.
Большинство моделей, естественно, выходят со встроенными «перилами», которые не дают им разговаривать на «опасные» темы. Сообществу Open Source такое не нравится, поэтому все новые модели достаточно быстро переучивают, убирая веса с цензурой и отказами. В мире РП это вообще необходимо, да и в целом не очень приятно попросить модель написать небольшой вирус для игры в захват флага, и получить «это может быть опасно, я вам не скажу». Однако обычно такие штуки находятся в приватных репозирориях HF (надо зарегистрироваться, и нажать галочку "принимаю риск") Или на других ресурсах. Стоит отметить, что хоть удаление цензуры становится эффективнее и эффективнее — это все равно редактирование весов, что может повлиять на стабильность, и добавить артефакты. Я за 3 года сталкивался с проблемами всего пару раз, но это то, о чем стоит знать.
Модели с которых стоит начать (на момент написания статьи)
Для ролеплея
Artemis от TheDrummer. Drummer один из лучших (если не лучший) тренер РП моделей. У него есть и датасеты и ресурсы под это дело, поэтому все что я пробовал от него это стабильные, креативные модели, которые могут практически в любой сеттинг — от космоопер до средневековых фуррей. Последние модели особенно хороши, но требуют больше памяти. Очень советую начинать именно с них. Зацените его репо, и выбирайте под свои возможности
Whatever Sophosympatheia is doing. Ее датасеты просто что то с чем то, и ее методы тренировки оставляют за собой замечательные модели, с которыми приятно РПшить. Ее StrawberryLemonade это возможно лучшая модель, с которой мне довелось играть. Умная, инициативная, пишет красиво, остается в персонаже, не пытается говорить за тебя, помнит про уши и хвосты и даже про течение внутри-РПшного времени. Буквально лучше, чем многие 120B модели. Но большевата, да…
Mawdistical.
фурри приветНачал он достаточно вяло, но в последнее время от него выходят достойные модели, заточенные на фурри ролеплей. Так что если вам важно, чтобы модель соблюдала анатомию вашего полу-дракона-полу-акулы это к нему.
Honorable mention. Некоторые люди, особенно увлеченные, тренируют модели специально на датасетах своих любимых вселенных, как например Animus, которая натренирована для максимальных познаний во вселенной Wings Of Fire. Так что если вам что то такое прям очень интересно — стоит поискать
Для всего остального
Qwen 3.8 Distil 9B. Небольшая модель для кодинга, которая замечательно себя чувствует на 12-ти гигабайтных видекартах. Она не просто квантизирована, а «обучена» своим же большим собратом. Написала мне пару сайтов — пишет чисто, хорошо понимает задачи.
Qwen 3.8 Ridge. Это для тех, у кого есть 16 гигов (квен очень не любит оффлоадинг). Очень хитрый квант, который оставляет важные слои на полном Q8, что дает непревзойденную точность в программировании и задачах по сравнению с моделями того же размера. Замечательный агент.
Gemma 4 12B. Небольшая моделька от Гугла, которая чуть более разносторонняя. Похуже в коде, но получше во всем остальном. Подскажет как приготовить блюдо, поймет PDF документ, перескажет книгу. Подгружаю, когда нужно что то более широкое. Вот вам и расцензуренная, на всякий.
Настройка и запуск
Модель подобрали, цель обозначили — можно запускать. Но и тут нас встречает раздолье разнообразных инструментов. Для рабочих и рутинных задач обычно хватает Ollama, LocalAI, AnythingLLM и прочих All-In-One решений. Однако для РП нам необходим более гранулярный подход, поэтому будем ставить компоненты отдельно.
Для бэкэнда будем использовать Koboldcpp. Это замечательный, шустрый бэк, который по сути является оберткой llamacpp, но с графическим интерфейсом и удобным выбором параметров. и написанный фуррями. Можно скачать бинарник, можно собрать из исходного кода. Тут уж как кому удобнее. Устанавливать ничего не надо — запускаем программу, выставляем контекст, выбираем файл модели и готово! Через несколько секунд (или минуту, зависит от железа) у нас в браузере открывается чат. Пишем «привет» для проверки, и если модель ответила — все работает как надо!
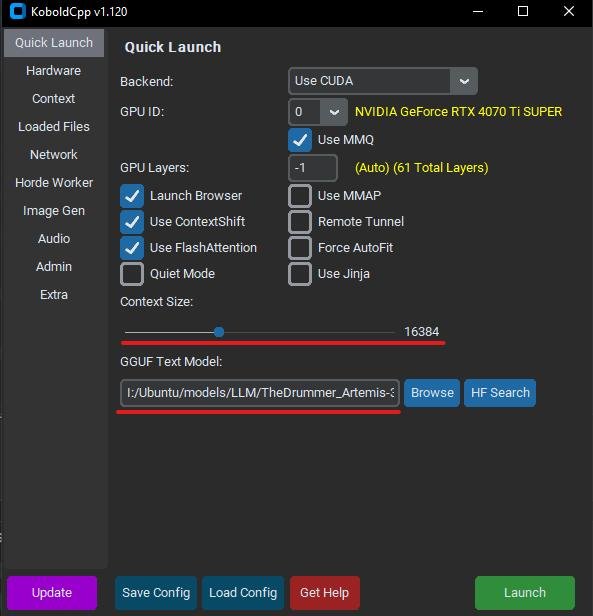
В целом, тут можно бы и остановиться. Для многих Кобо достаточно — в него можно закидывать карточки персонажа, есть необходимые настройки и минимум он выполняет.
Но мы же тут не для минимума?
Поэтому двигаемся к следующему шагу, ради которого вся подготовка собственно и велась. РП фронтэнд. SillyTavern.
Это ультимативный Фронт для ИИ РП, лучше которого я еще не встречал. Тут есть вообще все, что может понадобиться. Однако как и с любым хорошим инструментом, ее использование может вызвать дезориентацию. Официальное руководство находится тут, и в целом если вы пользуетесь компьютером на +- уверенном уровне, то проблем возникнуть не должно. Устанавливаем node, клонируем репо, запускаем стартовый скрипт. Если все сделали правильно — в дефолтном браузере откроется окошко.
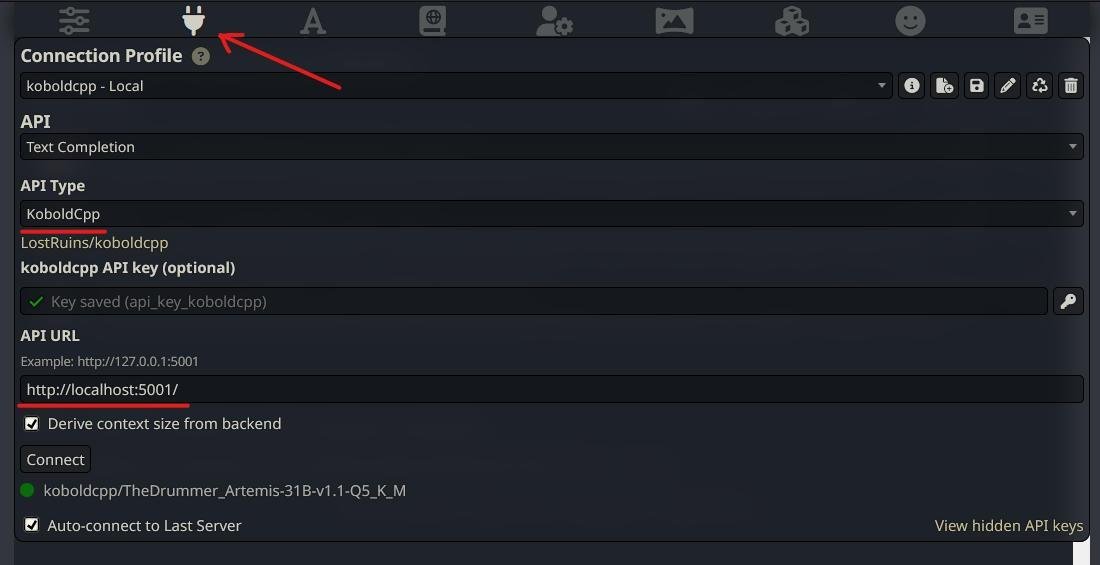
Бэк есть, фронт есть — осталось это друг с другом объединить. Заходим в вилку, выбираем API Type — KoboldCpp, в адрес "http://localhost:5001/" и жмакаем «connect». Все позеленело? Замечательно! Мы на финишной кривой прямой. Нам осталось настроить модель, и найти персонажа. Чтобы настроить модель, в 80% случаев достаточно зайти в ее карточку на HF (HuggingFace), и найти ссылку на настройки. Это будет файлик в формате json.
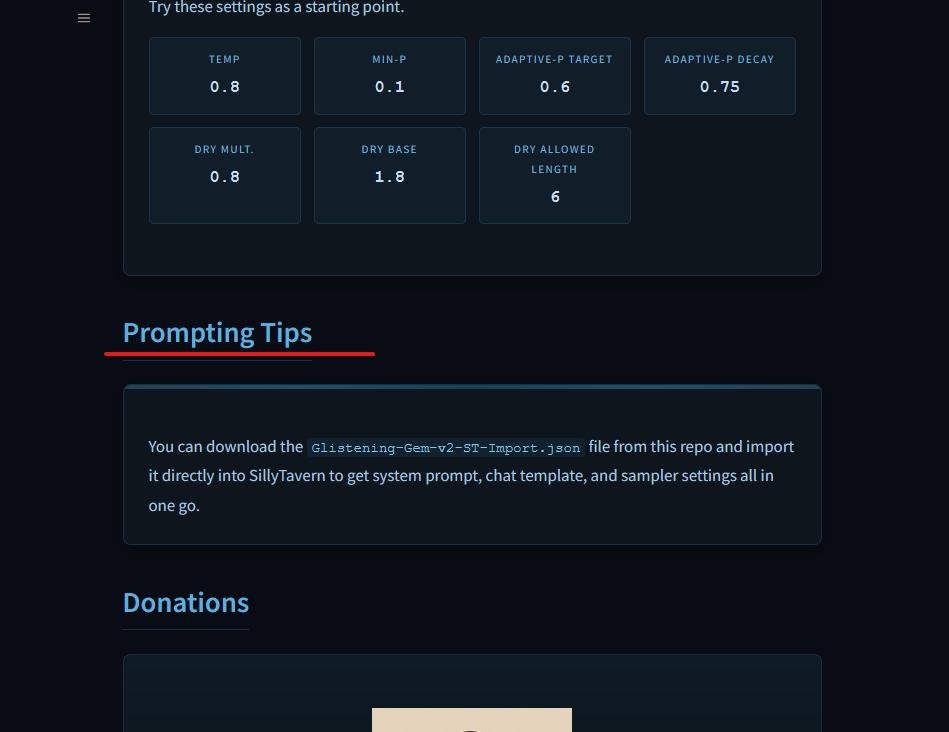
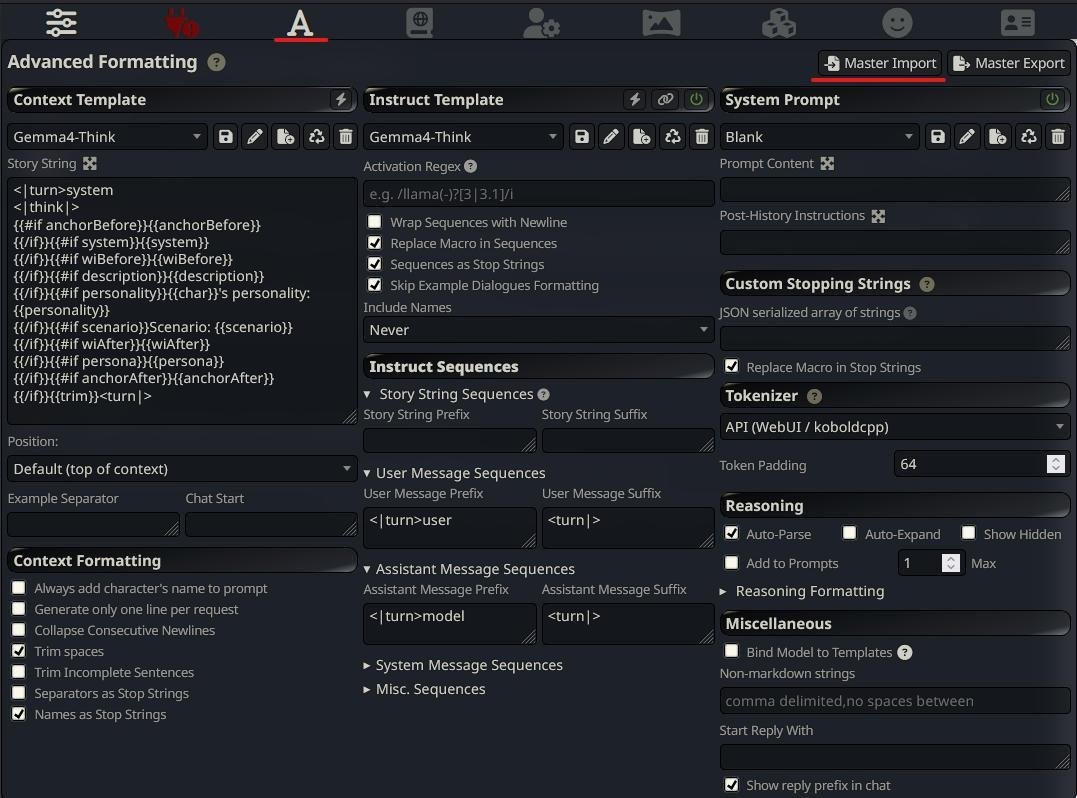
Скачиваем, и закидываем в ST кнопкой Master Import. Теперь модель готова примерить любую маску, которую вы ей дадите. Так что идем на Chub, botbootu, Janitor, и находим того, с кем хочется поговорить. Скачиваем карточку в png (чтобы аватарка была), и закидываем в ST.
????
PROFIT!!!1
Данный сетап, даже со старенькой моделью и 16к контекста будет несравнимо лучше любого облачного РП сервиса (привет c.ai) по всем параметрам. Никаких отказов, значительно меньше затупов, и никаких проблем с «мы обновили модель, привыкайте к новой».
Но мы можем сделать лучше.
Подстройка
Это уже очень опционально, и для тех, кто чуть чуть поиграл, и чувствует что модель может лучше, или для тех, кто хочет поэкспериментировать с параметрами, которые обычно прячут за красивыми интерфейсами. Одно из больших преимуществ ST, ради которого люди идут на такие вот изврщения — это полный контроль на моделью. Так что пару слов про…
Samplers.
Это то, что влияет на алгоритмы, по которым модель выбирает следующий токен. То есть правильная настройка дает красивый слог, который не повторяется, а плохая выдает белиберду. Настройки в карточке модели это достаточно усредненные и стабильные, с них очень хорошо начинать, и потихоньку подстраивать под себя.
Если хорошо знаете английский, то есть просто замечательный гайд, который описывает все самплеры детально. Я же попробую быть максимально кратким.
Еще очень советую открыть вот этот сайт, и потыкать на самплеры, подвигать слайдеры, чтобы визуально понять, что они делают. Как говорится — лучше один раз увидеть.
Min P это возможно важнейший самплер из доступных, особенно для РП. Он устанавливает жесткое ограничение на то, какие токены модель может использовать, тем самым убирая из ее репертуара совсем уж неподходящие слова. Злоупотреблять им не стоит, или можно серьезно подпортить модели креативность.
Хорошее правило для этой настройки:
- Скучные, однообразные ответы — опускаем Min P на 0.005
- Безумные, несвязные ответы — поднимаем Min P на 0.005
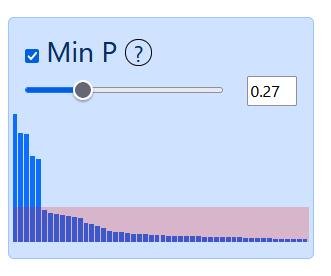
(Красным выделяются те токены, которые отфильтровываются)
Temperature это «выравниватель», который уменьшает, или увеличивает разброс между возможными токенами. Низкая температура приводит к предсказуемым, конкретным ответам, но может загнать модель в петлю, когда она не в состоянии двигать сюжет. Высокая же выдает более креативные и непредсказуемые генерации, но может ломаться, галлюцинировать и выдавать несвязные предложения. В целом настраивать ее стоит так же, как и Min P, и не забывать подгонять этот самый Min P под температуру (Ведь мы меняем возможность получения токенов). Стандартное значение у этого самлера — 1.0
DRY Repetition Penalty это по сути «наказание» модели за использование одних и тех же токенов. На графике его, к сожалению, нет, но принцип работы достаточно простой. После использования какого-либо токена, DRY снижает вероятность его выбора.
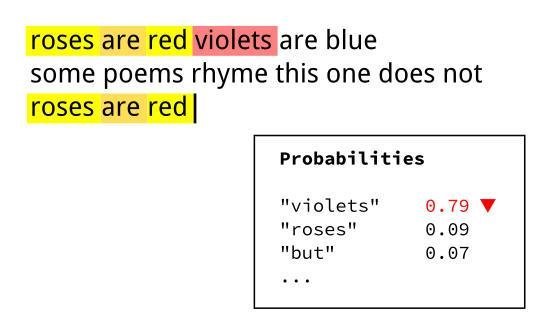
(Картинка украдена у разработчика)
Это не значит, что модель не может его снова использовать, если он самый подходящий, но очень сильно помогает избавиться от петель. Дефолтные настройки от разработчика (0.8 DRY Multiplier, 1.75 DRY Base, 2 DRY Allowed Length, 0 Penalty Range) работают в 99% случаев, однако если модель продолжает упорно повторяться, можно снизить Allowed Length на 1. А если начинаются проблемы с грамматикой, то соответственно поднять на 1.
Это основные параметры, которыми я пользовался, и которые хоть как то понимаю. Но и их мне хватало, чтобы вытащить «средненький» РП на уровень «Вау, и это ИИ?» Однако я коснусь еще пары важных на мой взгляд самплеров, с которыми экспериментирую
Top nsigma это новый подход к фильтрации токенов, что приводит к конфликту с Min P. Однако на моем опыте, он работает несколько лучше, чем Min P, отфильтровывая токены более эффективно и позволяя выкрутить температуру сильнее без потери связности. Большинство шаблонов для моделей уже используют его вместо Min P, однако если настраиваете сами я бы советовал выставить Min P где то на 0.005, и играться уже с nsigma. Суть та же — если скучные однообразные ответы то поднимаем на 0.1, а если пошла белиберда то опускаем на 0.1
Тут главное найти баланс, который вас устроит.
Banned Tokens/Strings это уже когда модель надоела повторять одно и то же. Инструмент простейший — вписываем слова(или фразы), которые надоели, и они блокируются и больше не появляются. Стоит ли говорить, что с этим инструментом надо быть аккуратным, а то можно набанить всего и оставить модель без слов.
Про карточки персонажей
Еще один важный момент, который может сделать, или испортить РП — это карточка персонажа. У вас может быть замечательная модель, правильные настройки, и все равно средне-скучный РП. А все потому, что автор персонажа не удосужился его адекватно описать, и модель не понимает что с ним делать, скатываясь в заводской слог. Стоит помнить, что модель — это алгоритм поиска закономерностей, и чем больше и чем лучше примеров вы ей дадите — тем лучше она войдет в роль.
Отдельного упоминания стоит первое сообщение. НИКОГДА не оставляйте в первом сообщении какие либо действия или диалоги от своего лица — потому что даже умная модель будет пытаться за вас говорить. Еще раз — модели работают на ПРИМЕРАХ. Если первое сообщение — «Ты встал, открыл дверь, и увидел кошкодевочку», то не важно сколько системных сообщений в стиле «не пиши за пользователя» вы ей дадите — она будет следовать примеру, который вы дали. Самая лучшая идея — это дать максимум описания самого персонажа от лица персонажа (или от 3го лица, тут кому как удобнее) — «Резкий звук разбудил Эллен, и она приподнялась на локтях, пытаясь сфокусироваться на двери. Кто там?, — Спросила она сонным голосом». Писатель из меня конечно так себе, но смысл, думаю, понятен. Мы даем модели пример форматирования, диалога, и общего тона того, как хотим видеть ее ответы. Отличный пример того как надо делать, это встроенный персонаж SillyTavern — Seraphina.
Итоги
Фух. Вроде как, я написал про все, что хотел, и даже больше. Очень надеюсь, что читать эту простыню было интересно, потому что я первый раз пишу что то на публику, а не только для себя. Посему, буду очень рад конструктивной критике, и советам как можно улучшить свой слог, структуру и все остальное. Отдельный шаут статье, которая меня подтолкнула попробовать. А еще Кириллу за поддержку и помощь в редактировании!
Ну и конечно я надеюсь, что хотя бы кому то это было полезно. Даже если вы не собираетесь РПшить, базовое понимание ИИ сейчас достаточно важно, иначе это просто выглядит как магия.
See you space cowboy…

Вот примерно так нужно писать популярные статьи про GenAI, всё равно конечно ничего не понятно, но хотя бы ощущение, что что-то понятно.
Я на радостях пошёл попросил Клода пофиксить мой роадмап по изучению GenAI, может всё-таки пройду его до конца в итоге.
Очень круто.
Я сначала статьи думал, что РП - это руководитель проекта. И разговор, как сделать локальную модель в помощь такой роли) Тем не менее, отличный обзор выбора и запуска локального ИИ. Спасибо!
Я вот наблюдаю элементы кибер-психоза у людей просто от того, что ИИ с тобой всегда соглашается.
Как тусовка РПшников насколько осознанно они к этому подходят? Если рекомендации как не съехать с катушек?
Можно ли поделиться статьёй с другом, который этим увлекается?
Ещё один отличный пост о неизвестном для меня опыте и стороне жизни. Правда радовать себя или ИИ друга киберперчаткой по защищённому протоколу вряд ли начну. Интересно как скоро пойдут комменты от пожилых духоборов - "Не понимаю зачем этим добровольно заниматься" и "Пропаганда эскапизма, прочитают дети, гроб, гроб, убрать с главной ...итд"